收藏
基于OCR文字定位实现的桌面UI自动化思路——by.广州业务组

前言
之前社区举办了一场连连看活动,当时本着娱乐参赛的心态,用图片自动化的方式做了一个图片定位的实现和思路分享:
具体可看往期活动的内容:
🏆社区挑战 | 亚运Emoji项目,用影刀争夺胜利,这泼天的富贵终于轮到你了💸💸💸-应用设计交流-影刀RPA开发者社区
探索
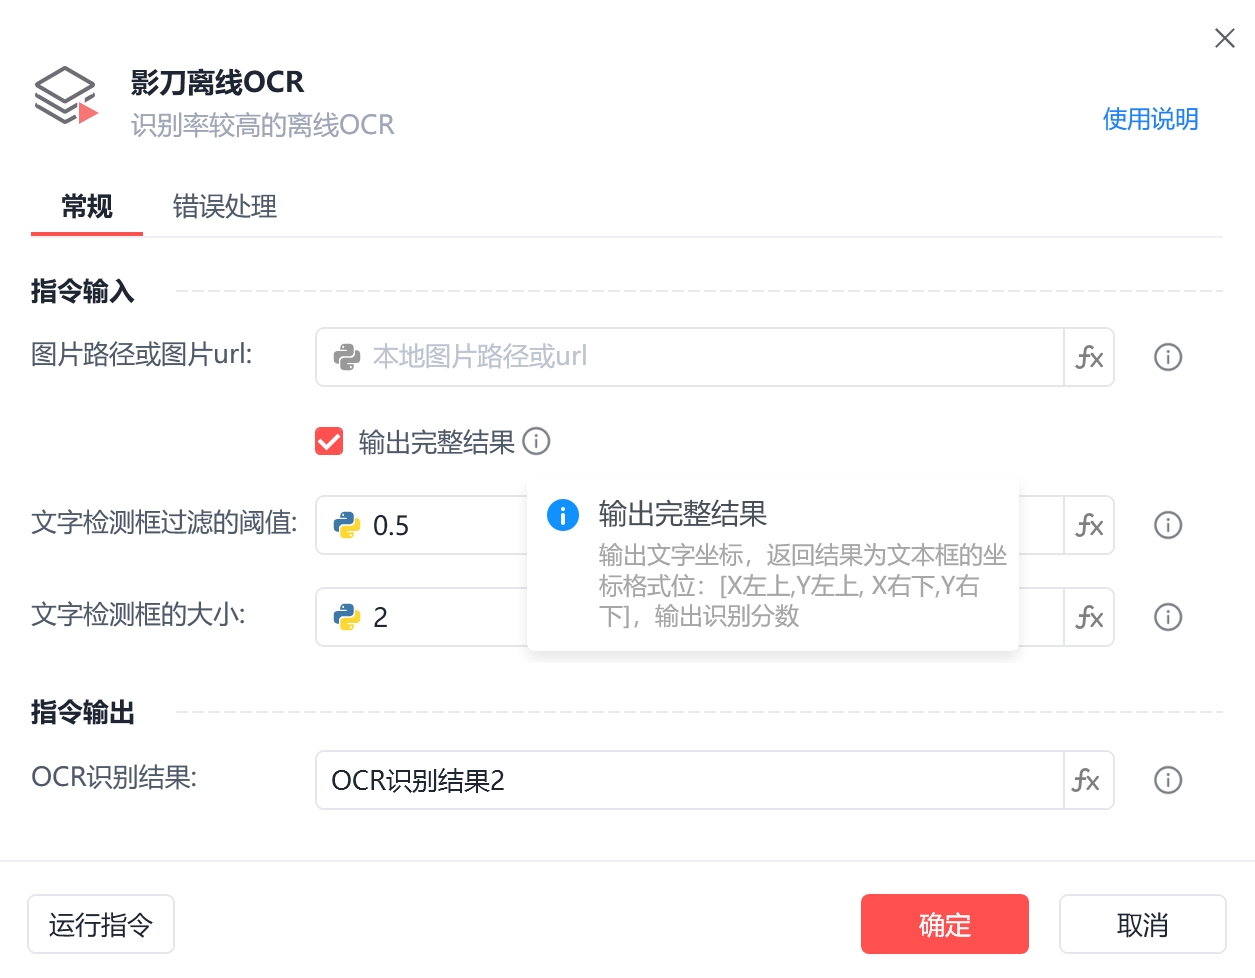
本着既然图片自动化都安排上了,那么图片自动化有没有哪些可以直接落地的场景呢,想来想去,把目光瞄准到了离线OCR识别这条指令上面,本次利用的是影刀离线OCR中"输出完整结果"的这个功能:
实践过程
比如,对一张图片中的文字进行识别,它会返回
{'text':识别结果,'score':相似度,'box':[x1,y1,x2,y2]}其中,box里面的数值,可以理解为相对于图片左上角(0,0)开始,其4个矩形边框的距离位置。
比如,这个Postgre和SQL的识别结果,就代表从左上角(0,0)开始,从上往下到识别到的结果的顶部/底部的距离,以及从左到右到达左侧及右侧的距离:
[{'text': 'Postgres', 'score': 0.88615906, 'box': [36, 226, 271, 305]}, {'text': 'SOL', 'score': 0.97299415, 'box': [248, 217, 415, 299]}]映射到图片里面,就大概长这样:
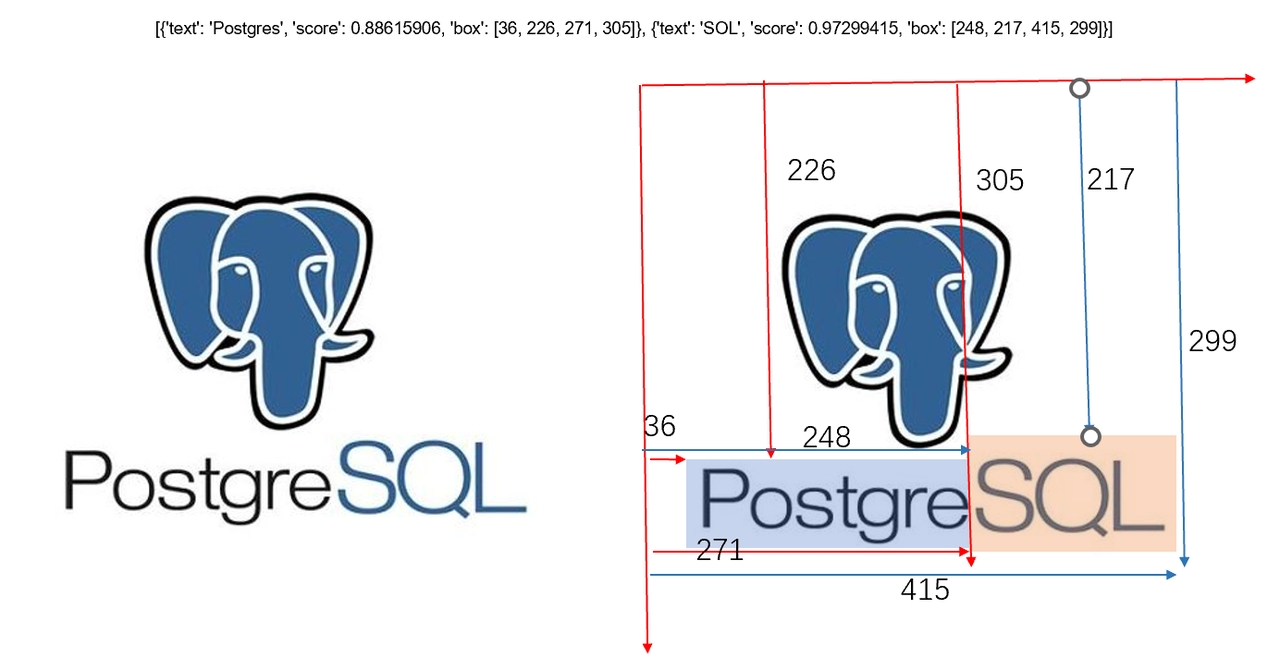
当有了这些box里面的位置,就可以求出被识别到的物体的矩形位置的4个角落的坐标,或者是根据4个角落的坐标,求出中心点的坐标了:
计算公式:
中心点X轴= (左上X轴+右下X轴)/2/屏幕缩放比
中心点Y轴= (左上Y轴+右下Y轴)/2/屏幕缩放比
根据上面思路,我们可以去思考,有一些软件(其实我在说企业微信),正常无法捕获内部的元素,但是有些按钮的位置相对固定,是否可以使用这种方法来实现识别文字后捕获呢?
于是,一顿搭建,将操作封装成一条指令:
核心逻辑如下:
- 传入一个win元素对象,
- 对win元素对象进行截图并保存到temp文件夹
- 将传入的元素对象进行强制激活,置顶到屏幕最前端
- 离线OCR识别出里面的所有能识别到的文字,组成一个列表
- 循环该列表,如果循环到的文字包含自己想要点击的文字,则将鼠标移动到相对于该元素左上角的对应x y轴位置并点击
- 退出循环(这里暂时没考虑到相似元素的情况,只点击第一个识别到的)
- 删除截图文件,确保隐私不会泄露
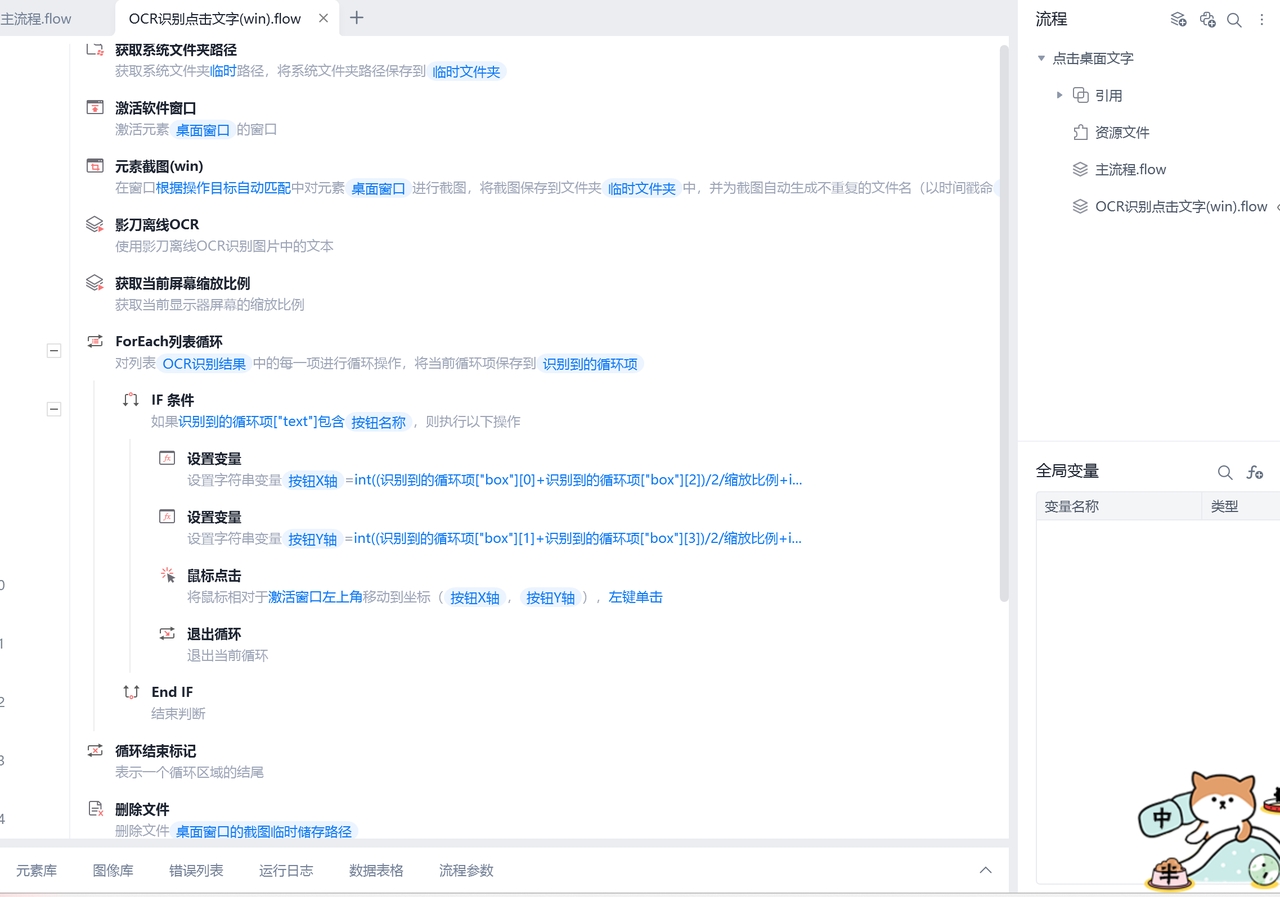
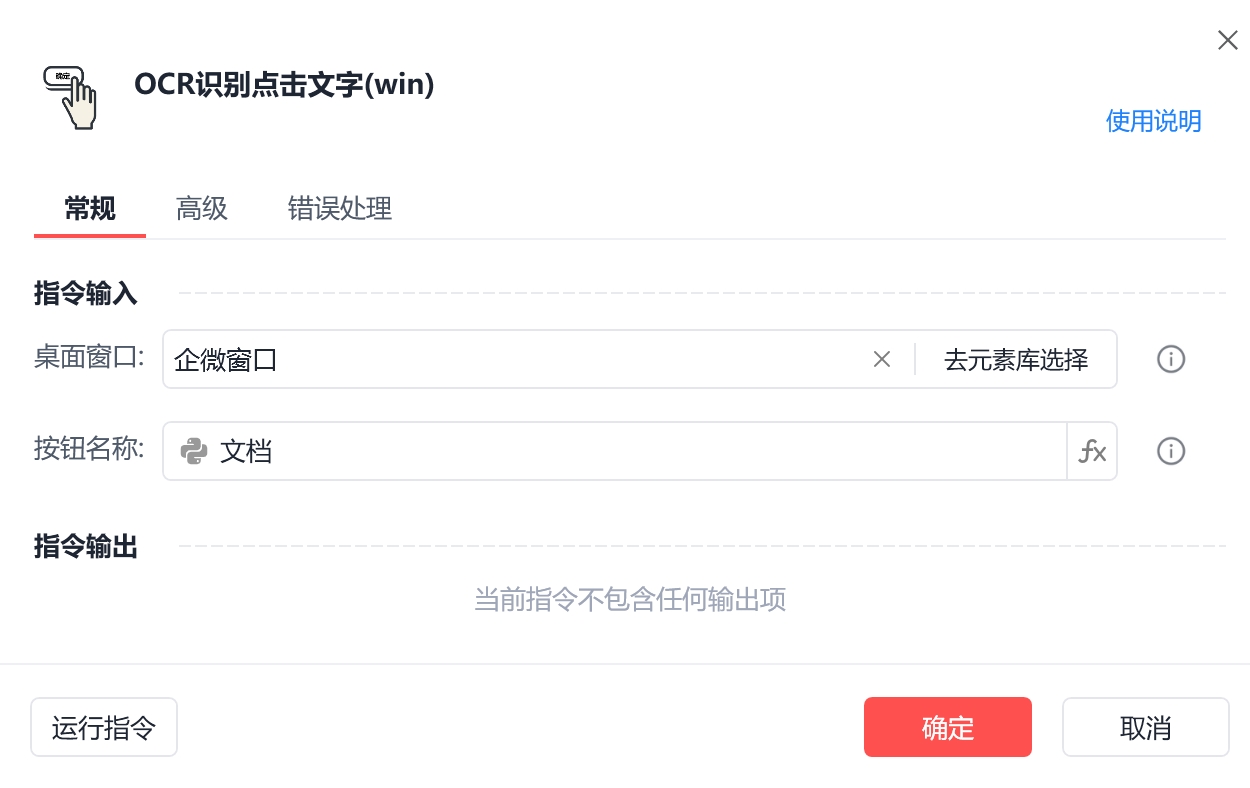
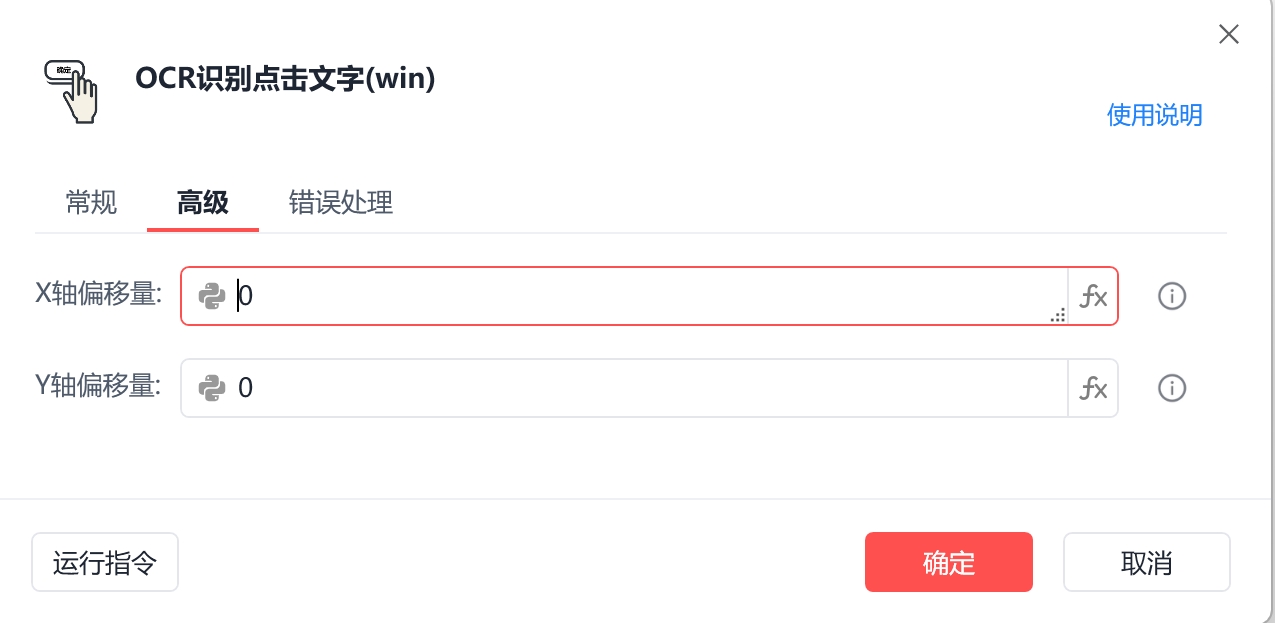
最后,对上面的指令稍微封装封装,就能变成一条美观实用的指令了:
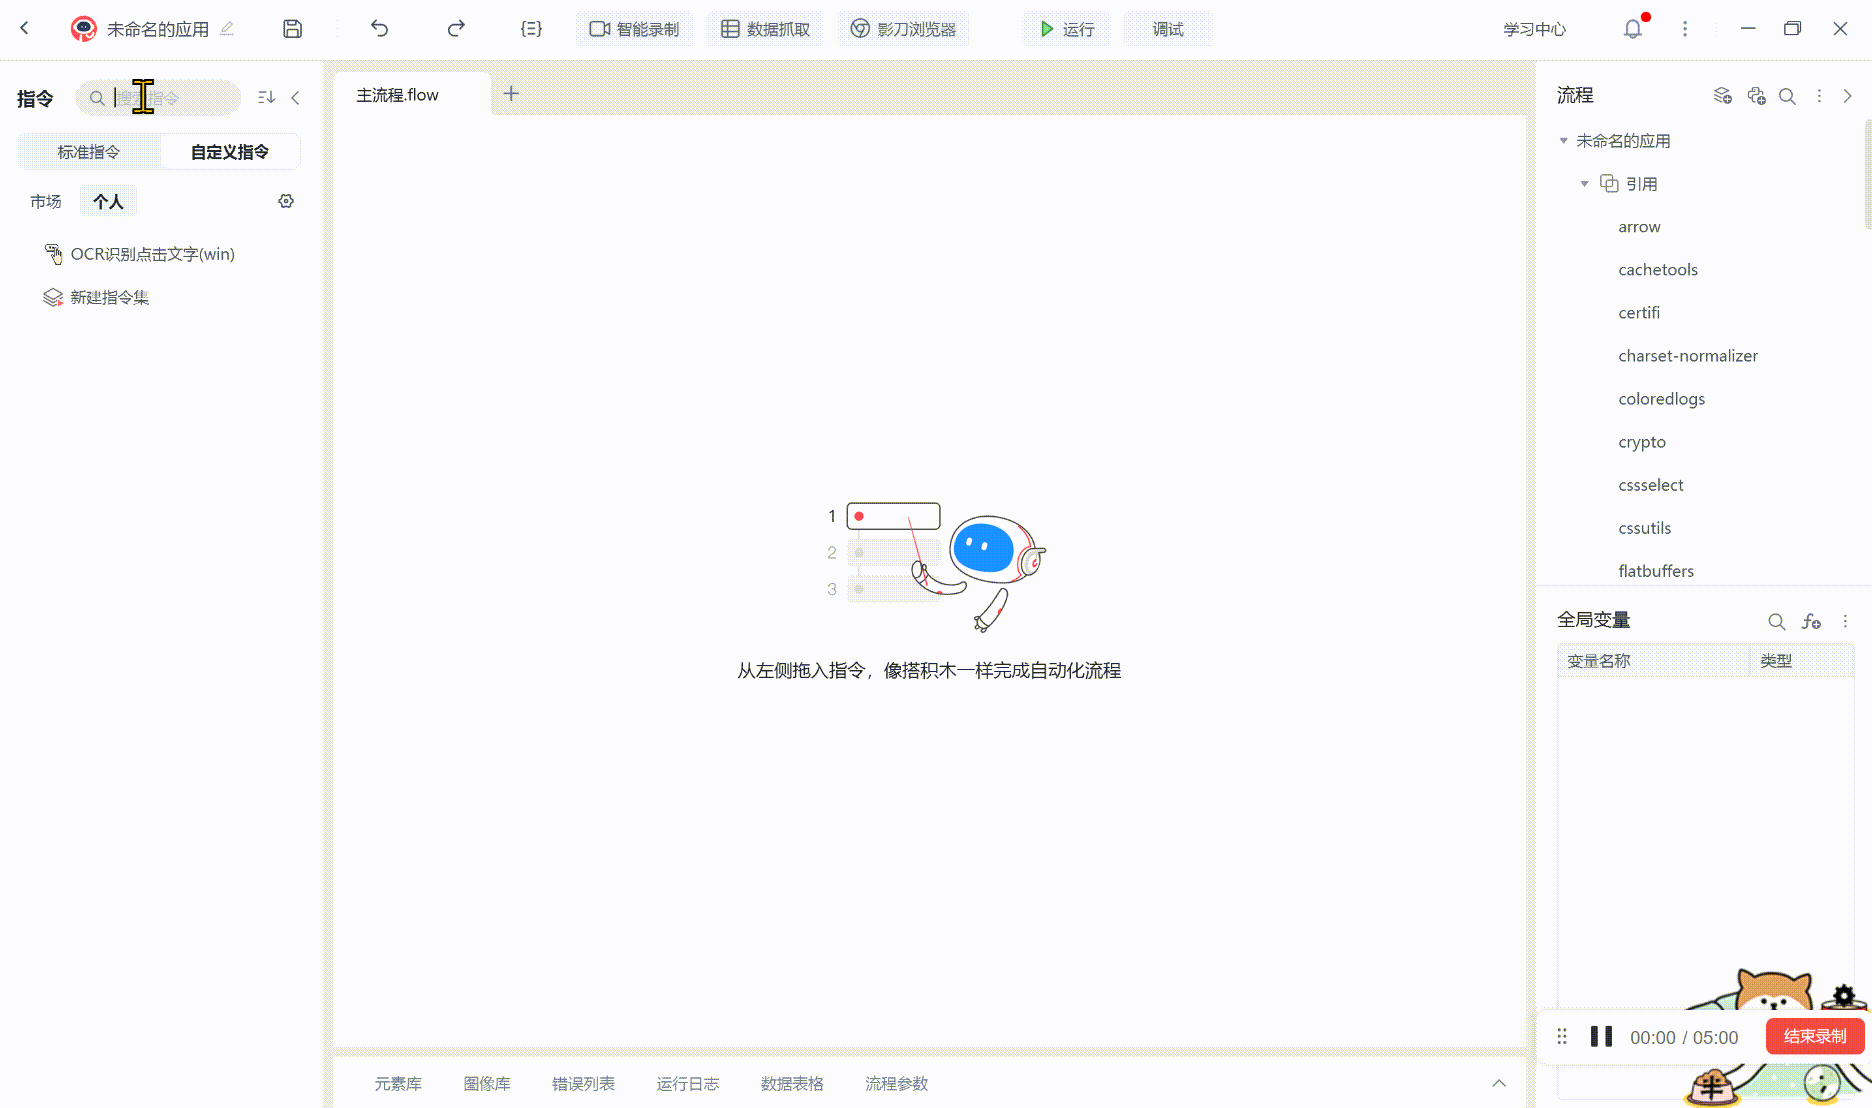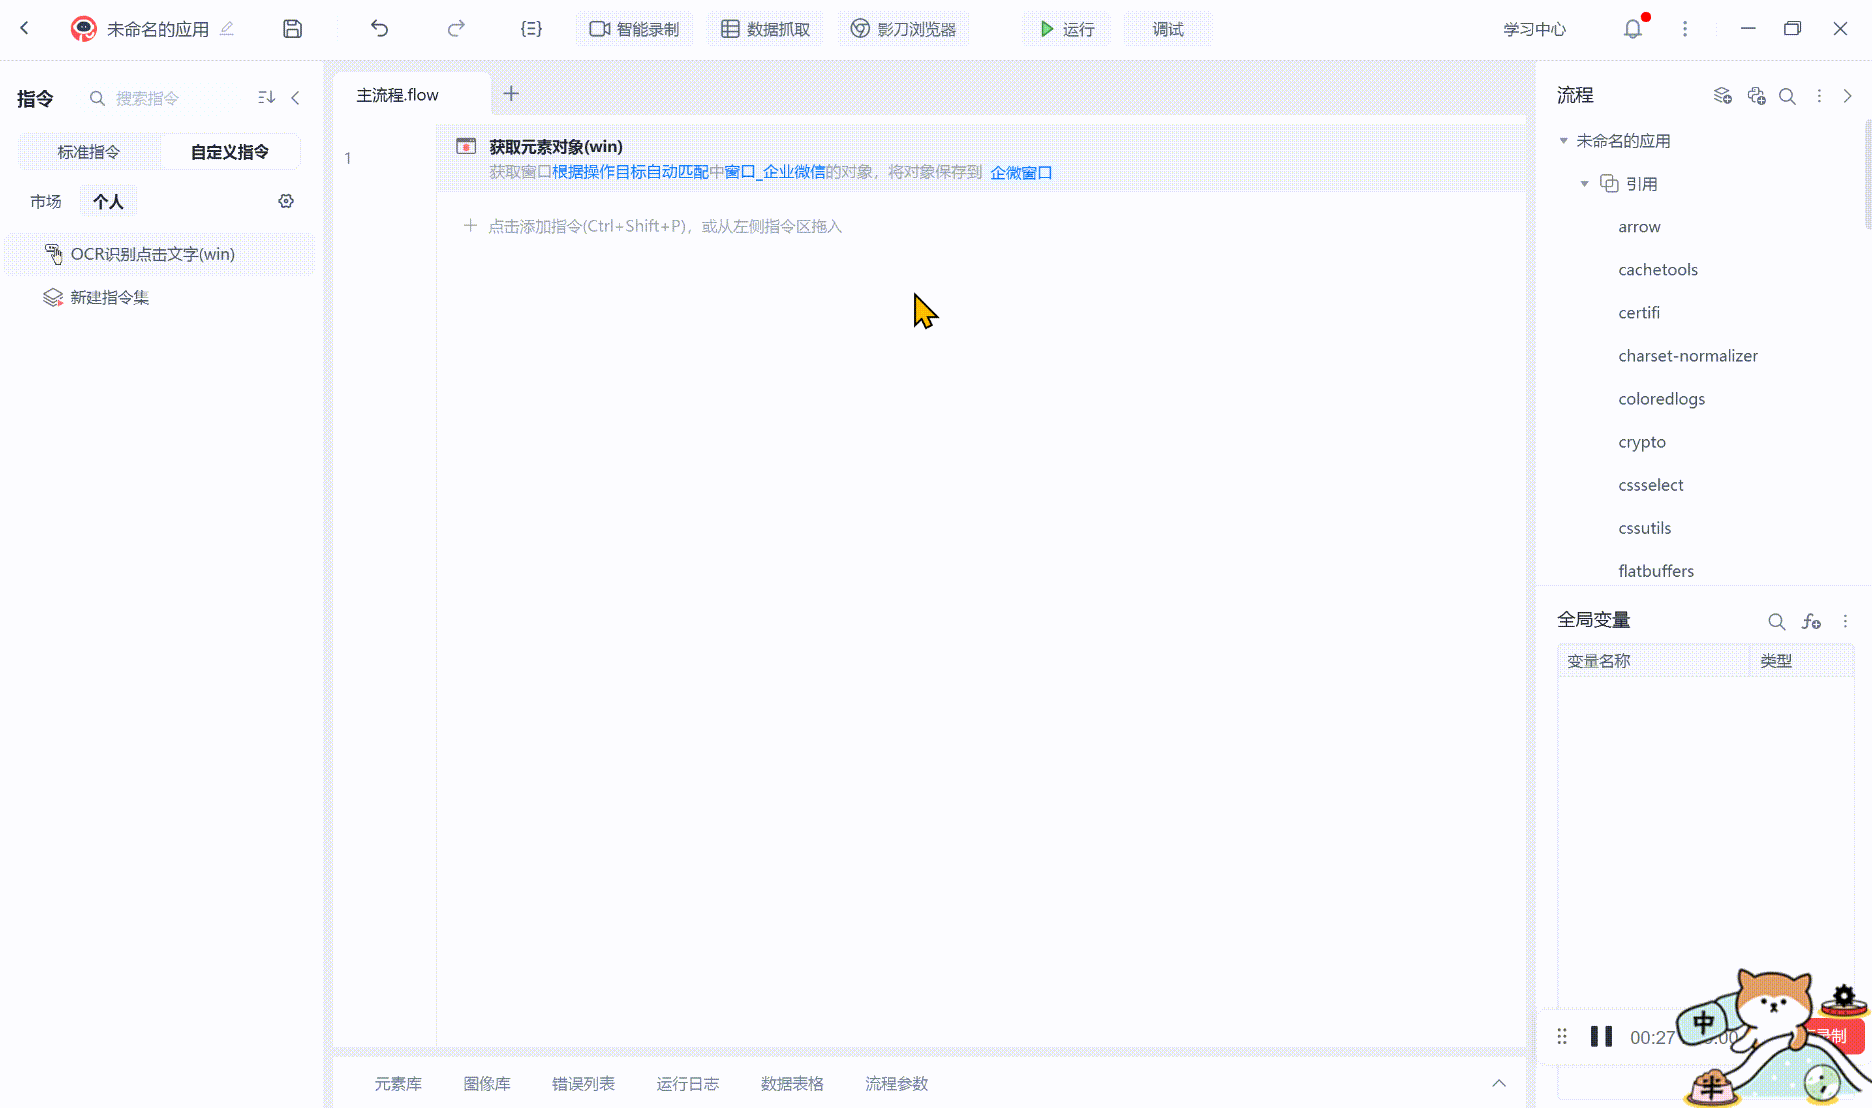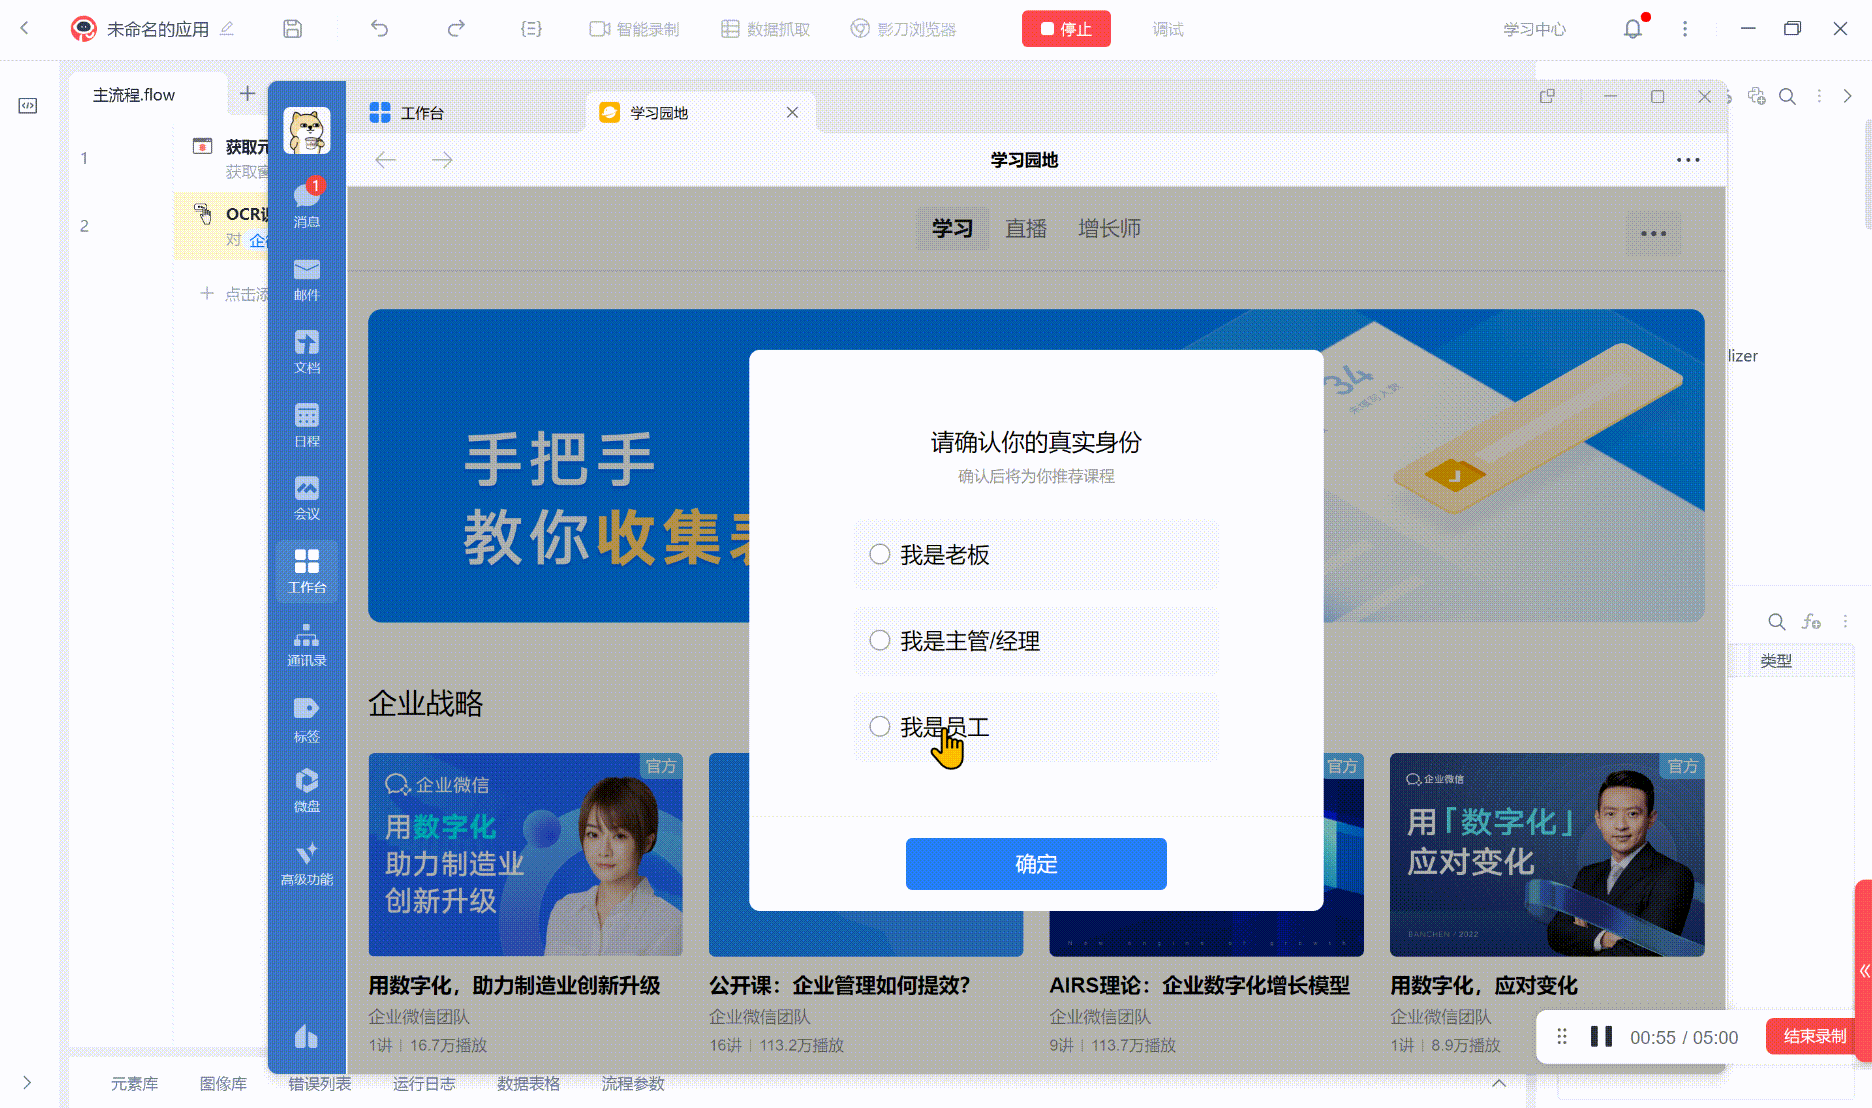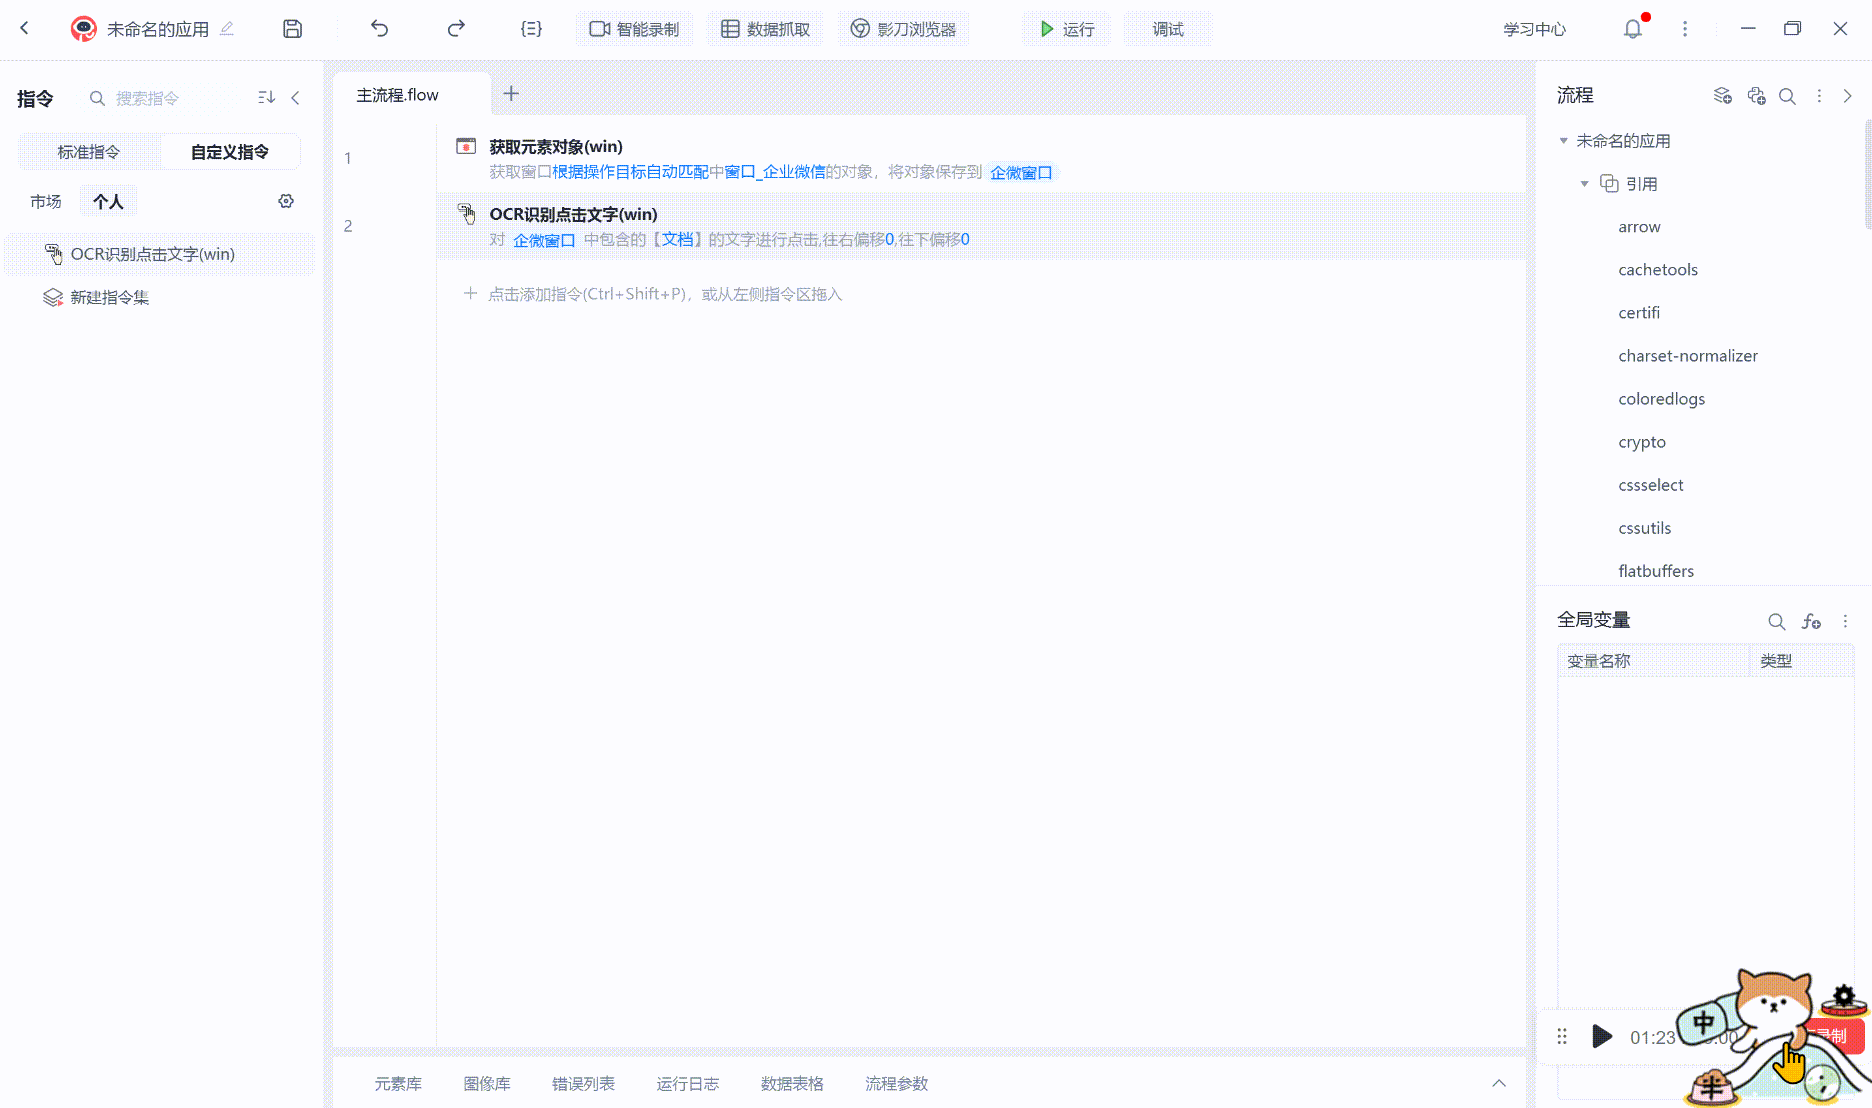
演示视频
最后,展示一下通过上述方法进行文字识别,实现点击企微内的文字的视频:
当然,这个是目前探索出来的比较简单的用法,对于一些比较固定的文字按钮,都可以用这个方法实现直接点击(包括网页元素),就可以省去获取元素,等的时间,也可以自己封装上一个X,Y轴的偏移值,实现点击图片周围一定距离的元素等等~
不过由于这个本质上是图片+坐标点击的一种混合的骚用法,可能还会遇到一些问题,比如,我上面举例子用到的postgreSQL, 其中的SQL就被识别为SOL,这个可能需要换个更高精度的文字识别模型(代表着更贵),还有部分点击操作可能需要按辅助按键(ctrl),或者需要双击等,本次虽然都没去实现,但是要实现起来都非常的简单,小伙伴可以去试着探索如何自己根据我这个demo截图去实现这部分的功能~~
收藏10