收藏
实时对话的模糊搜索任务 技术文档
场景描述
在用户咨询场景中,需要基于用户的聊天式的问答 提取用户问题并回答。
任务核心
对话场景的搜索和传统的搜索引擎这两个有很大的差距。
例如一个用户咨询一个AI问题(AI是一个店铺咨询助理的身份),对话场景的搜索和传统的搜索引擎 差距在于对话场景更加自由。因为真正的对话是肯定得上多轮的,因此用户往往不会提供一个精准的搜索问题,他会在过程中思考,他会先提出一个疑问,然后在对话的过程中逐渐丰满这个问题的具体相关信息,因此这里就有个很关键的问题是需要用户引导,需要让AI引导用户去填充信息。
客户是很懒的,他们想要聊天对话中获取信息的入口,需要入口 精准/有价值。因此给用户发送 搜索信息(或者说启动搜索action)时机要把控好,在搜索的时候兼顾信息引导。
任务痛点
- 用户引导。
- 恰当的时机启动知识库搜索。
用户引导部分(agent框架部分)
设计思考
- 去平衡LLM的能动性,不能把他框的太死。但是也不能什么都依靠function call或者让LLM直接生成构建graph的代码。平衡不好做,因为传统的产品作为的是0到1的过程,但是基于LLM的agent可以看作一个产品,他做的是从1到10的过程,可以把LLM看作更泛化的判断和生成,但是需要找到10的边界,毕竟做不到从1到100.
- 平衡效果和时间开销。为了LLM思考更加细化,我们可能会通过思维链的方式让LLM逐步思考,但是这样串行的设计时间开销是个很大的问题。因此需要考虑在整个框架设计中增加并行的步骤。
具体步骤
Question info graph:{"用户问题":"衣服推荐","对话记录":"具体对话记录","init_用户输入":"问下有啥衣服","子问题":["1.用户需要男装还是女装","2. 用户心理价格区间"]}
Question info graph cache:[{"用户问题":"鞋子推荐","对话记录":"具体对话记录","init_用户输入":"有啥鞋子","子问题":["1.用户需要男鞋还是女鞋","2. 用户心理价格区间"]},{"用户问题":"衣服推荐","对话记录":"具体对话记录","init_用户输入":"问下有啥衣服","子问题":["1.用户需要男装还是女装","2. 用户心理价格区间"]}]
existed_user_question_list =[i["用户问题"] for i in question_info_graph_cache]
- 判断当前用户回复是否需要知识库,若不需要则直接回答用户问题即可。
- 如果当前用户回复需要基于知识库,则提取用户问题,判断用户问题是否在existed_user_question_list 中,如果 不在则初始化graph添加到cache中。
- 当新建一个用户问题的时候,需要让LLM思考该问题可以从哪几个相关方面考虑,类似发散思考,就是question_info_graph中的子问题部分。
- 让LLM判断回答该用户问题所需要的相关信息(所需的相关信息可参考子问题)能否基于对话记录 较好提取。如果可以,就请 生成 接下来用于基于知识库匹配的用户问题,要求尽可能准确的传达用户问题,并且涉及用户提到的相关信息。如果不可以,就请继续参考相关子问题继续向用户提问。

RAG 基于知识库问答
我们原先基于LLM进行直接问答,但是发现LLM不知道,或者说需要让LLM基于一定的知识问答,因此自然而然有了RAG(Retrieval Augmented Generation)。RAG核心在于从知识库中检索到与用户问题相关的语料然后输入给LLM作为背景信息。
看了Retrieval Augmented Generation or Long-Context LLMs? A Comprehensive Study and Hybrid Approach这篇论文。从LLM角度来说,如果LLM 的context足够大,其实直接把整篇文档丢给LLM作为prompt的一部分也是可以的,我们称之为long-context(LC)。当RAG检索到正确完整的信息的时候,LC效果可以和RAG持平。当RAG检索不全,LC的效果将高于RAG。当整篇文档在context中塞不下的时候,LC效果下滑。当在context塞的下的情况下,RAG有个好处是节省token.
目前RAG常用的手段是将一篇文档进行chunk分割(就是文档切片),然后通过向量相似度和用户问题进行匹配检索出向量相似度最高的几个chunk作为背景信息。
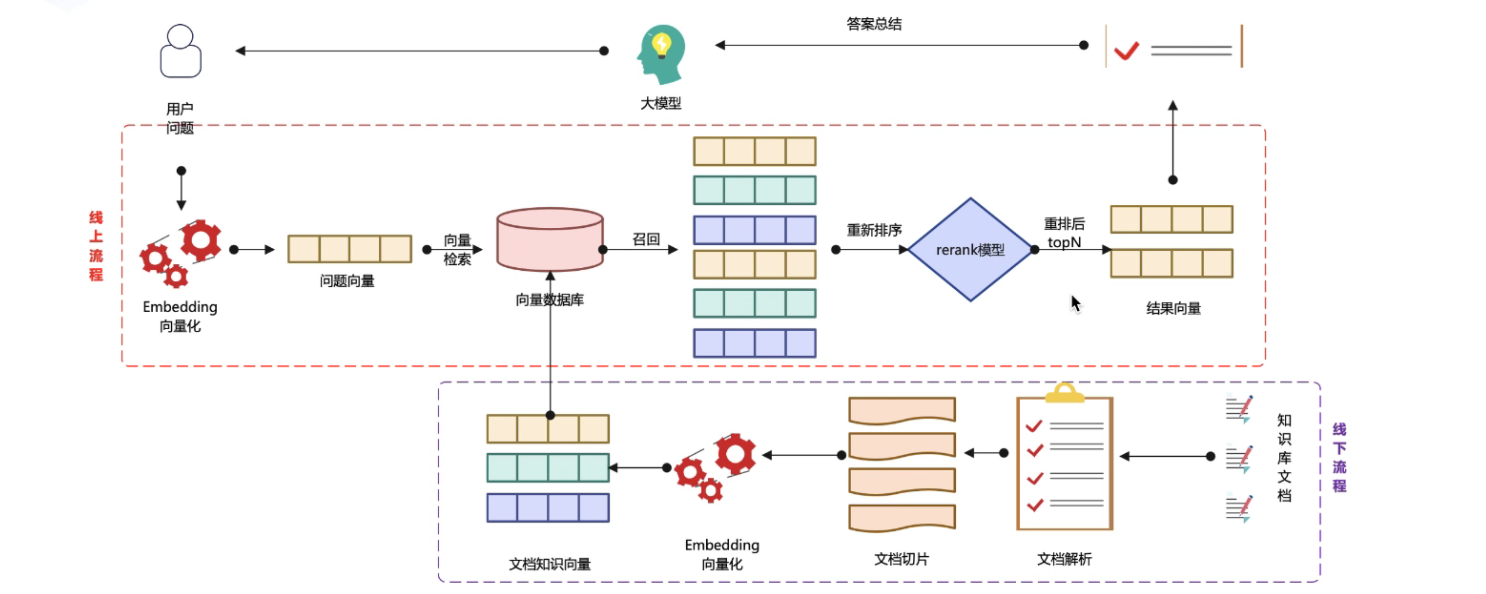
但是显然这套思路有个问题,就是用户问题如果需要参考的知识来源于文档的不同地方,需要的参考信息在文档分布很散,那么就不太行,最经典的场景为文章总结类的问题。
因此RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval(https://arxiv.org/html/2401.18059v1#S3)提出了逐层聚类的构建知识库算法:
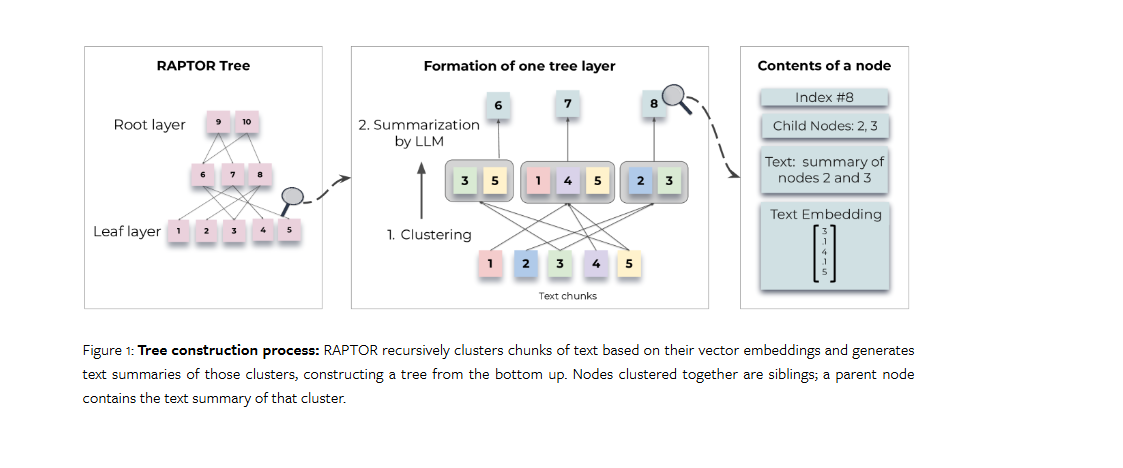
首先将知识库文档进行chunk分割,再将每个chunk进行embedding,作为leaf layer,然后逐层对该层的所有节点进行聚类,然后将聚类后的节点信息进行总结生成该聚类后节点的text,逐层聚类逐层总结,形成tree结构的知识库。也就是越偏向root layer,节点所包含的信息越偏向总结。
检索有2种方式,一种方式是将用户问题在知识库中逐层往下查找信息。另一种方式是将tree状的知识库直接打平成一维,将用户问题embedding和所有节点embedding进行匹配。第二种测试效果更好。
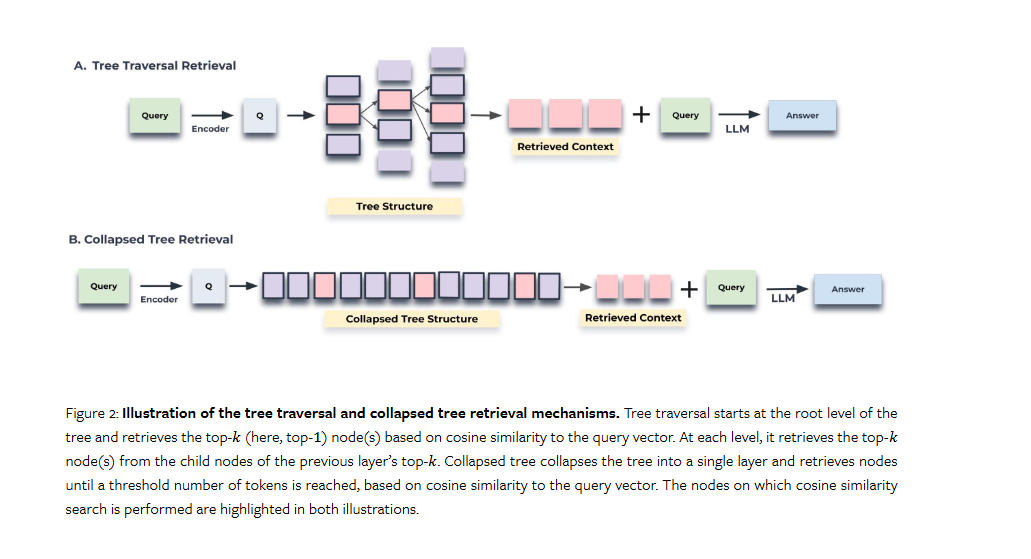
那么针对一篇长文档基于该论文构建tree知识库,然后基于该知识库检索回答是可以的,可以回答用户高语义的问题。
那么问题在于有几十篇长文档呢?将所有文档进行拼接作为一篇为文档构建tree么?这个解决方案应该不是最佳的,会面临多个问题。构建tree知识库每层layer的时候节点数太多导致很难聚类。
因此我的设计方案是将每篇长文档单独构建一个tree知识库(也就是说几十篇文档就是几十个tree 知识库),然后每篇文档再进行总结,类似给每篇文档打标签的形式。通过这种手段先确定用户问题可能参考哪篇长文档,然后再从参考文档对应的tree知识库进行具体检索。
我的想法是进行多层的知识库方案设计,将整套RAG系统作为有层级的系统,逐层去定位信息。
如果一篇文档很短,各个文档平级。其实只需要定位到文档后,将整个文档全部内容通过LC全部塞到prompt中即可。
因此如果需要真的构建一套针对业务场景的知识库,我个人认为应该基于实际业务场景的数据量,数据之间关系(包含可互相参考,还是互相独立)等实际情况进行构建。
如果觉得我说的有一定价值,欢迎进一步私聊。
联系方式:1903536218@qq.com
可备注知识库应用场景。
收藏2