收藏
影刀2023终竞赛-操作题二:PDF数据提取及处理
 影刀见习开发者
这个主要依赖于编码版实现。
1.多选文件
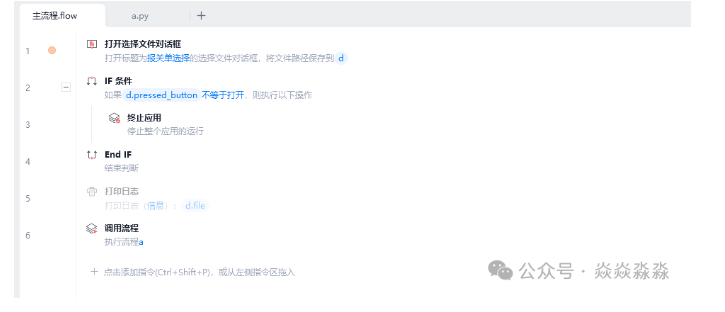
这个没什么好讲的,跟操作题四一样的,我就复制过来,选中多个pdf。
2.数据处理
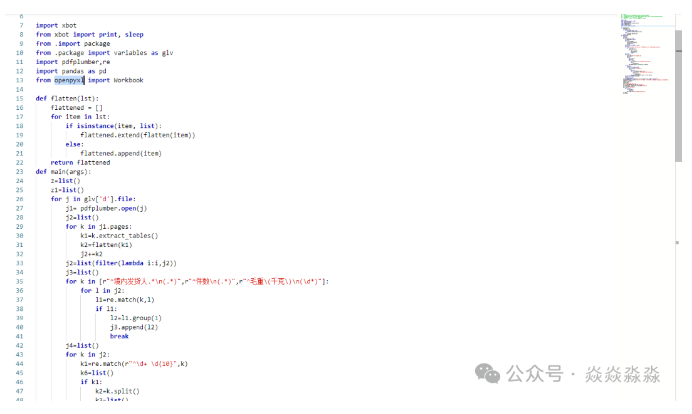
这个全部用python实现。
需要安装三个库,pandas,pdfplumber,openpyxl
2.1以表格来读取pdf
for j in glv['d'].file:
j1= pdfplumber.open(j)
j2=list()
for k in j1.pages:
k1=k.extract_tables()
k2=flatten(k1)
j2+=k2
j2=list(filter(lambda i:i,j2))
j3=list()
这个其实就是按pdfplumber操作就好,值得注意的是,我将读出来的多维列表数据转换成一维列表。
最后会将一维列表的里空的去掉。
def flatten(lst):
flattened = []
for item in lst:
if isinstance(item, list):
flattened.extend(flatten(item))
else:
flattened.append(item)
return flattened
这个就是递归函数。
2.2匹配 '境内发货人','件数','毛重(千克)'
[r"^境内发货人.*\n(.*)",r"^件数\n(.*)",r"^毛重\(千克\)\n(\d*)"]
分别三个正则匹配就好,这个没什么要点,因为每个报价单就一个。
这里有个小问题,毛重这个地方,示例表是28取整,实际上是28.95.
目前是按取整写正则。如果需要含小数,正则改成r"^毛重\(千克\)\n(.*)"
2.3 匹配'商品编号','商品名称','商品数量'
这个可能会存在多个,所以不能像2.2找到就break
2.3.1一般情况
一般情况,一行行商品,中间没和竖线隔开,整行会被读成一个单元格。
这时候用正则^\d+ \d{10},匹配以数字开头,中间有个空格,接着跟着10个数字的单元格。
这个里的前提,就是商品编号都是10位,并且按目前顺序。
接着按空格,把这个匹配中的单元格split成列表。
'商品编号','商品名称',k2[1][:10],k2[1][10:]
取列表第二项第二项,然后头十位就是商品编号,后面就是商品名称。
然后用正则r"^\d+[\u4e00-\u9fff]{1}$"匹配中 数字开头并且一个汉字然后结尾,用来寻找商品数量。
这个地方有个小问题
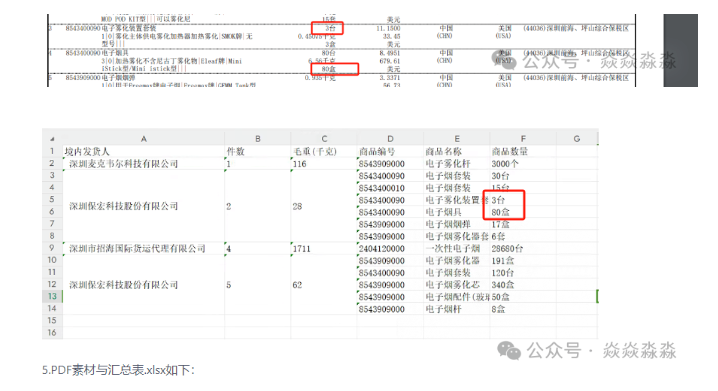
示例中3台位于第一个,80盒位于最后一个,我也不知道什么规律。
目前这个匹配方法,会把两个都匹配出来,我现在取k3[0]
想要最后一个,就列表里取k3[-1]
2.3.2 报价单4的情况
这个里每一行都切成标准的excel,一个个单元格。
我们先按2.3.1匹配,如果匹配不中,就执行2.3.2
r"^\d{10}$" ,先正则匹配只有十位数字的单元格,商品编号,把这作为锚点。
这个单元格往后一格,就是商品名称。
而往后两格,就是商品数量。
商品数量,使用正则r"^\d+[\u4e00-\u9fff]{1}$"
和上面2.3.1的商品数量正则就多个^,其实也没差。
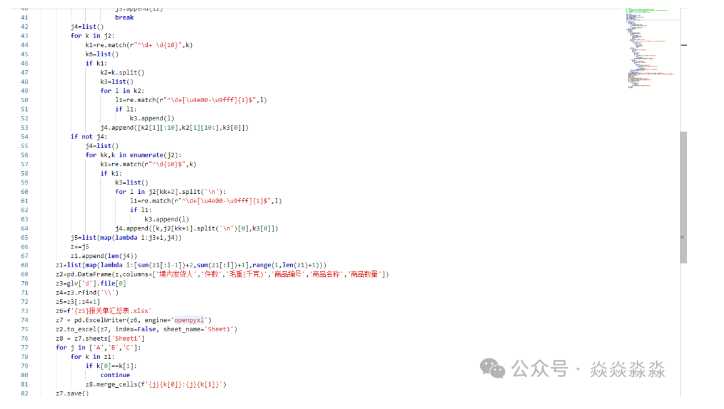
2.3.3 汇总数据
根据上面的步骤,把这些数据写成一个二位列表,然后转成pandas。
也记录每个报价单实际的行数,用于后面合并单元格。
2.3.4 写入数据
这个还是写入选取文件同个文件夹里
z1=list(map(lambda i:[sum(z1[:i-1])+2,sum(z1[:i])+1],range(1,len(z1)+1)))
这个z1 就是每个报关单实际占用的开始结束行序号。
for j in ['A','B','C']:
for k in z1:
if k[0]==k[1]:
continue
z8.merge_cells(f'{j}{k[0]}:{j}{k[1]}')
然后循环合并单元格。
当然,这个只有四个样本,实务上,这些正则能否生效,还有待商榷。
OK,如上就是我的整个思路逻辑。欢迎讨论交流。
收藏2