收藏
一些关于多条件筛选的小秘籍,望能助你秒变筛选达人!🚀

 发布于 2024-02-01 11:41更新于 2025-04-15 09:243027浏览
一、背景
相信绝大多数小伙伴在使用影刀处理Excel表格数据的时候都会用到 '筛选' 指令,但是目前 '筛选' 指令只在 等于 和 不等于 两种筛选类型下,支持使用python列表的形式进行传参来完成2个及以上的多条件筛选。当我们筛选的类型并非以上两种情况,并且条件个数大于2个时,难免会需要在指令中多次重复使用 '筛选' 指令来实现业务需求 
二、存在的问题
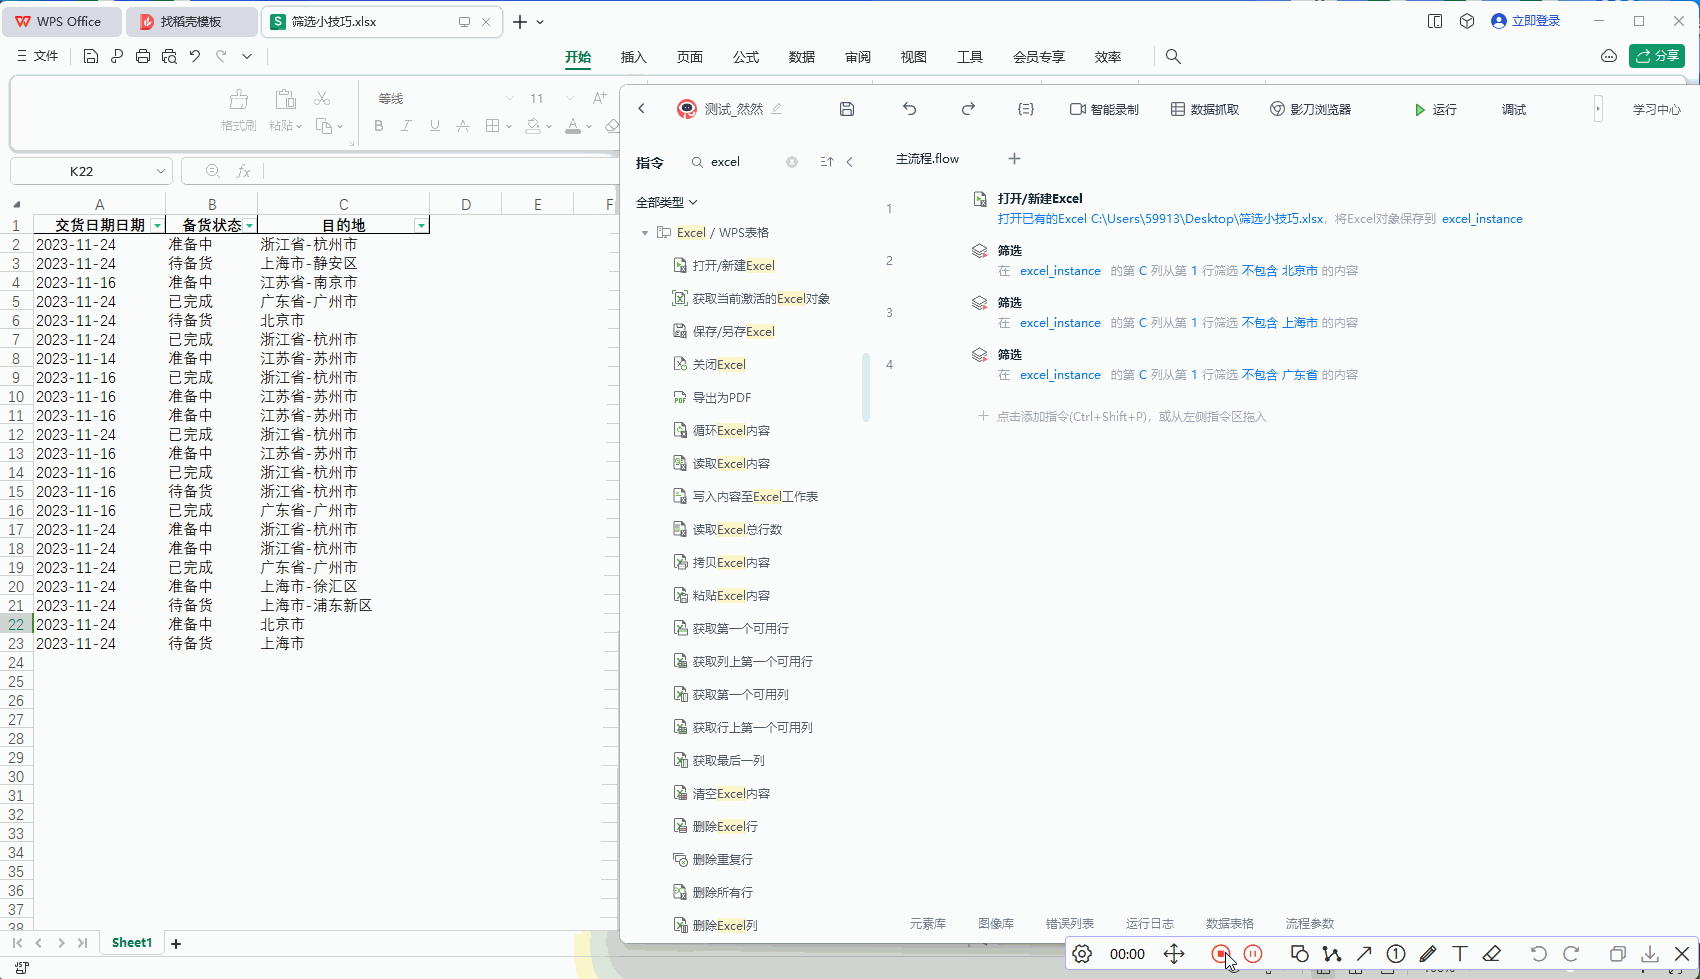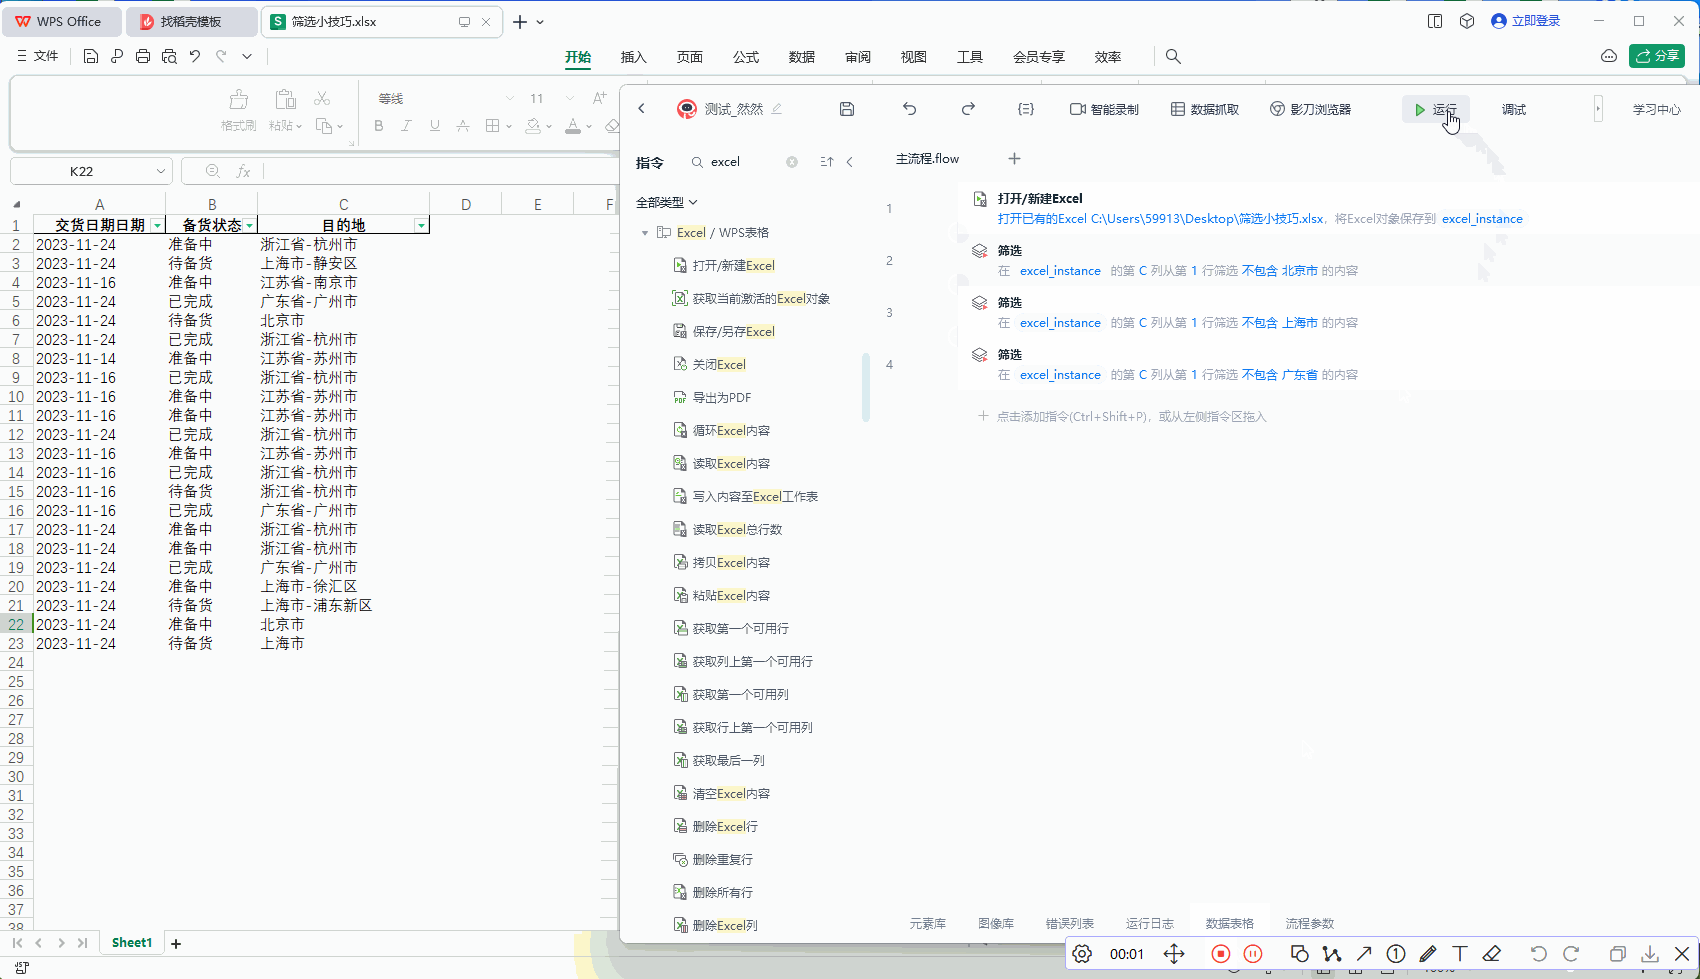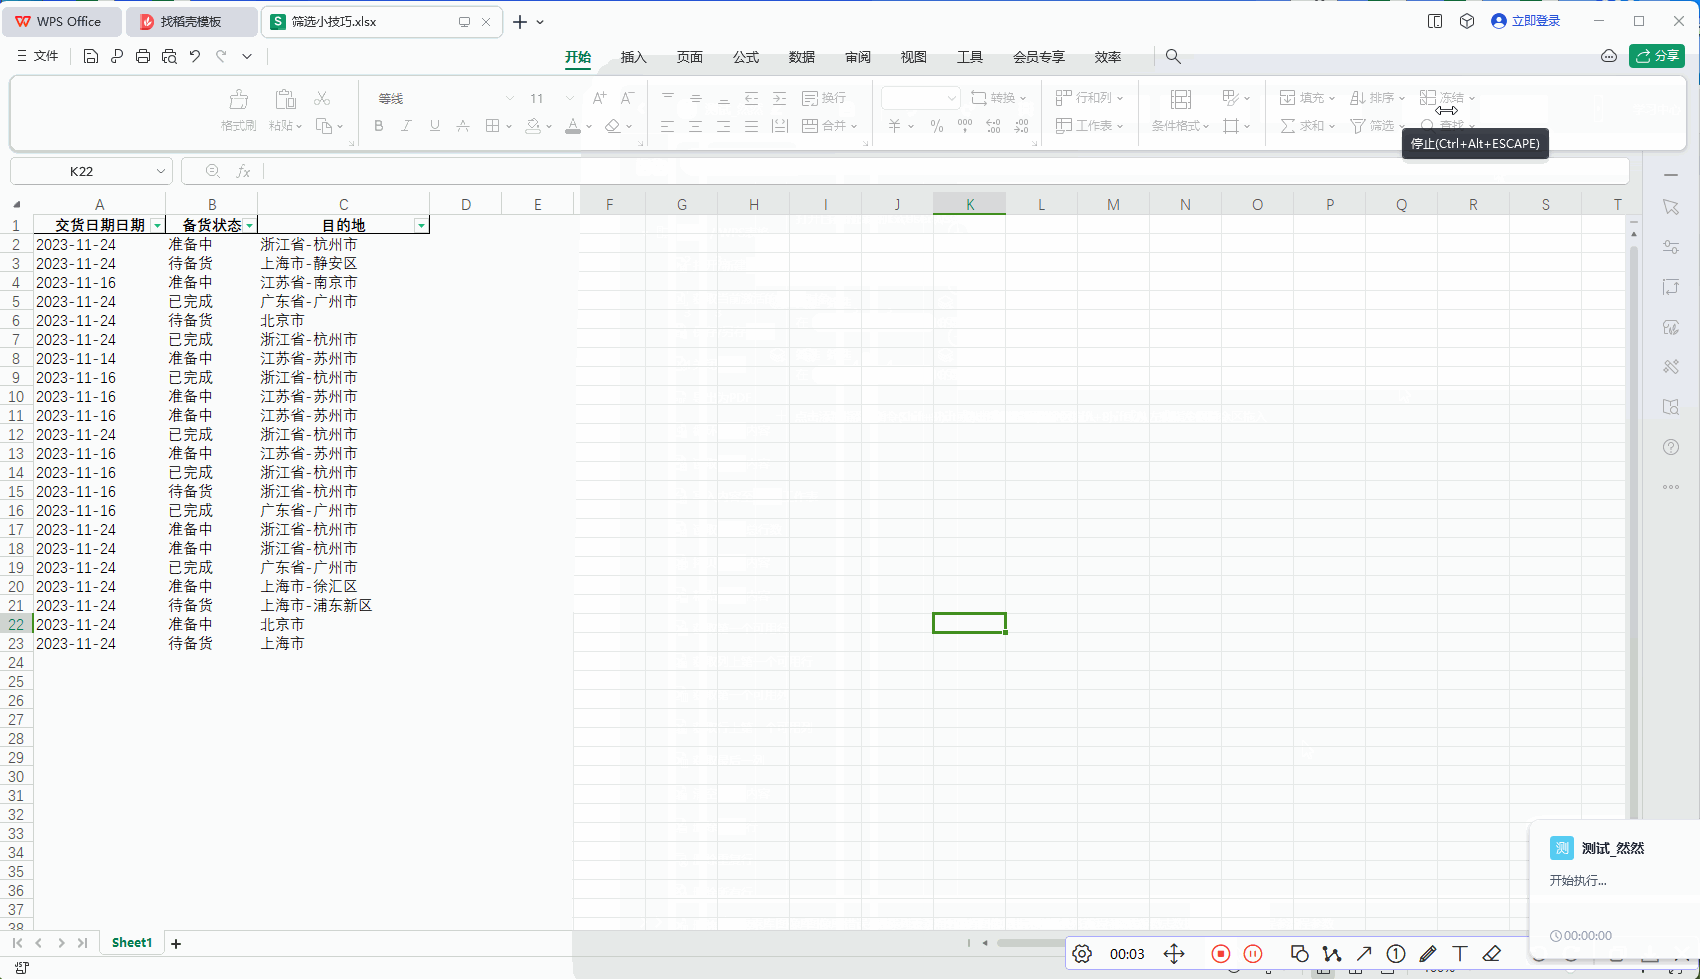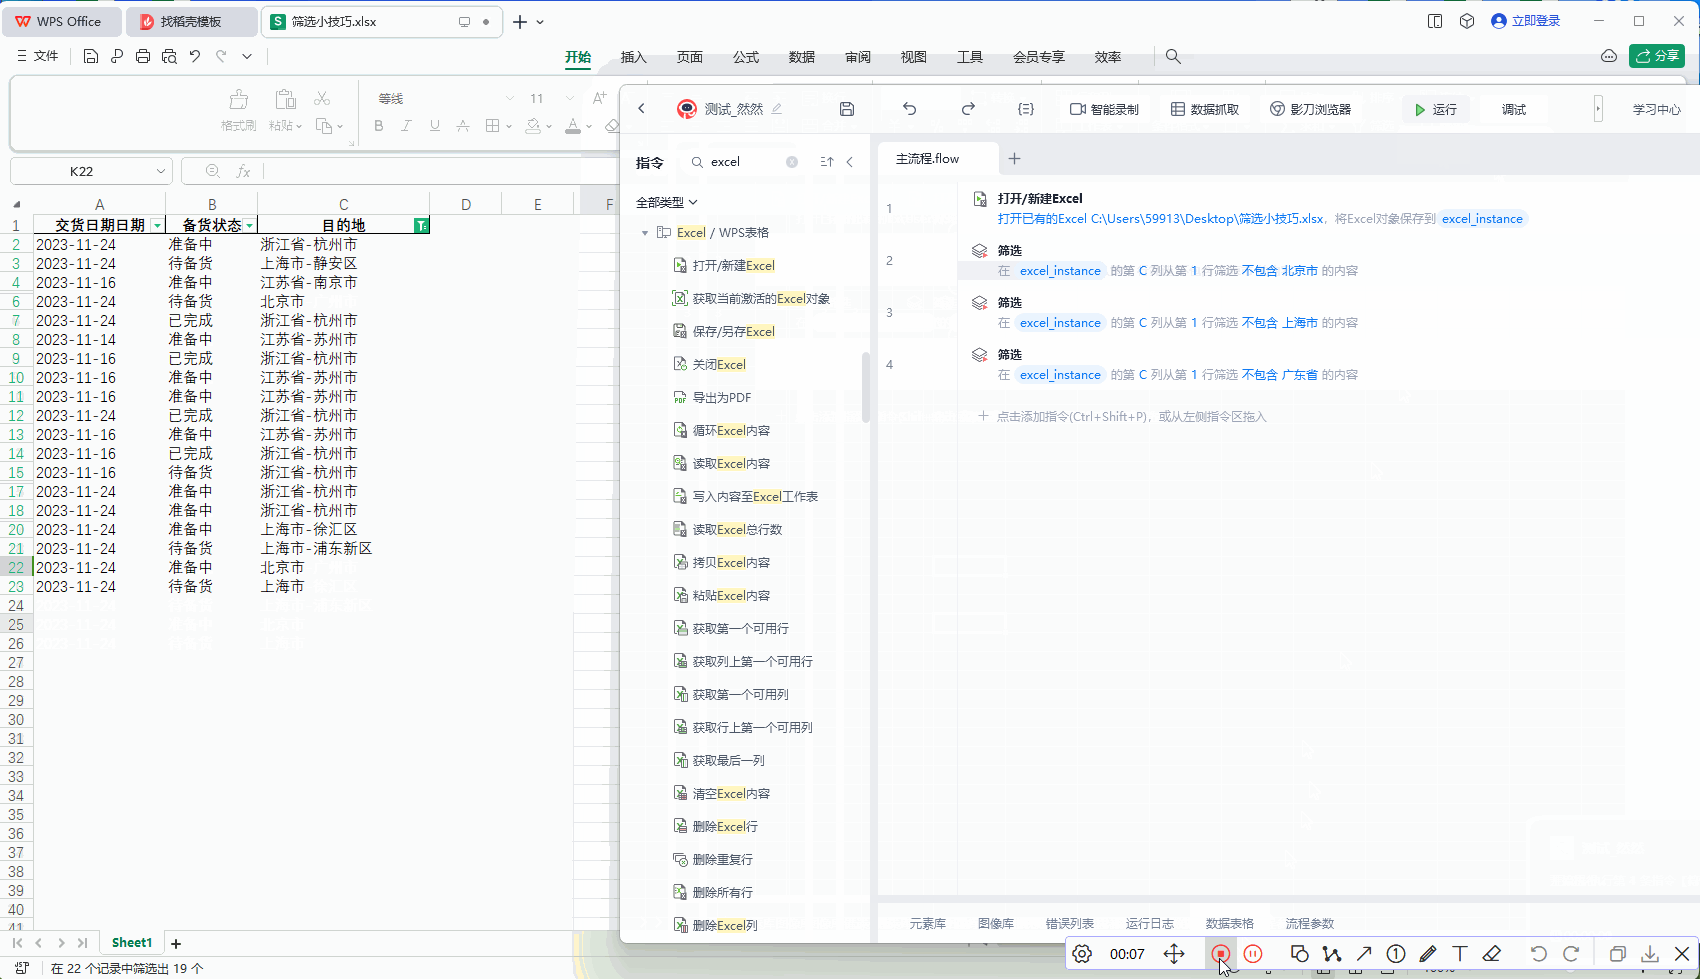
当流程使用了2次或以上的筛选指令对同一列数据进行操作时,位于后面的指令会将先前指令的筛选条件进行替换,并不能在先前指令筛选结果的基础上继续进行筛选,导致最终只会呈现最后一条筛选指令运行的结果。
就像下面这样(需要筛选C列不包含‘北京市’、‘上海市’和‘广东省’的数据,但是最终结果只是把不包含‘广东省’的数据筛选出来了)
三、解决方案
3.1 使用拷贝/粘贴Excel内容指令绕过问题
明白了问题的本质:无法在先前筛选结果的基础上继续进行筛选。那么解决这个问题的大体思路就是 执行完一次筛选后---对本次筛选的结果进行保存---再在此基础上继续筛选。
所以我们可以在一次筛选之后,拷贝筛选结果粘贴到新sheet页中,之后在新sheet页中继续进行下次筛选即可。
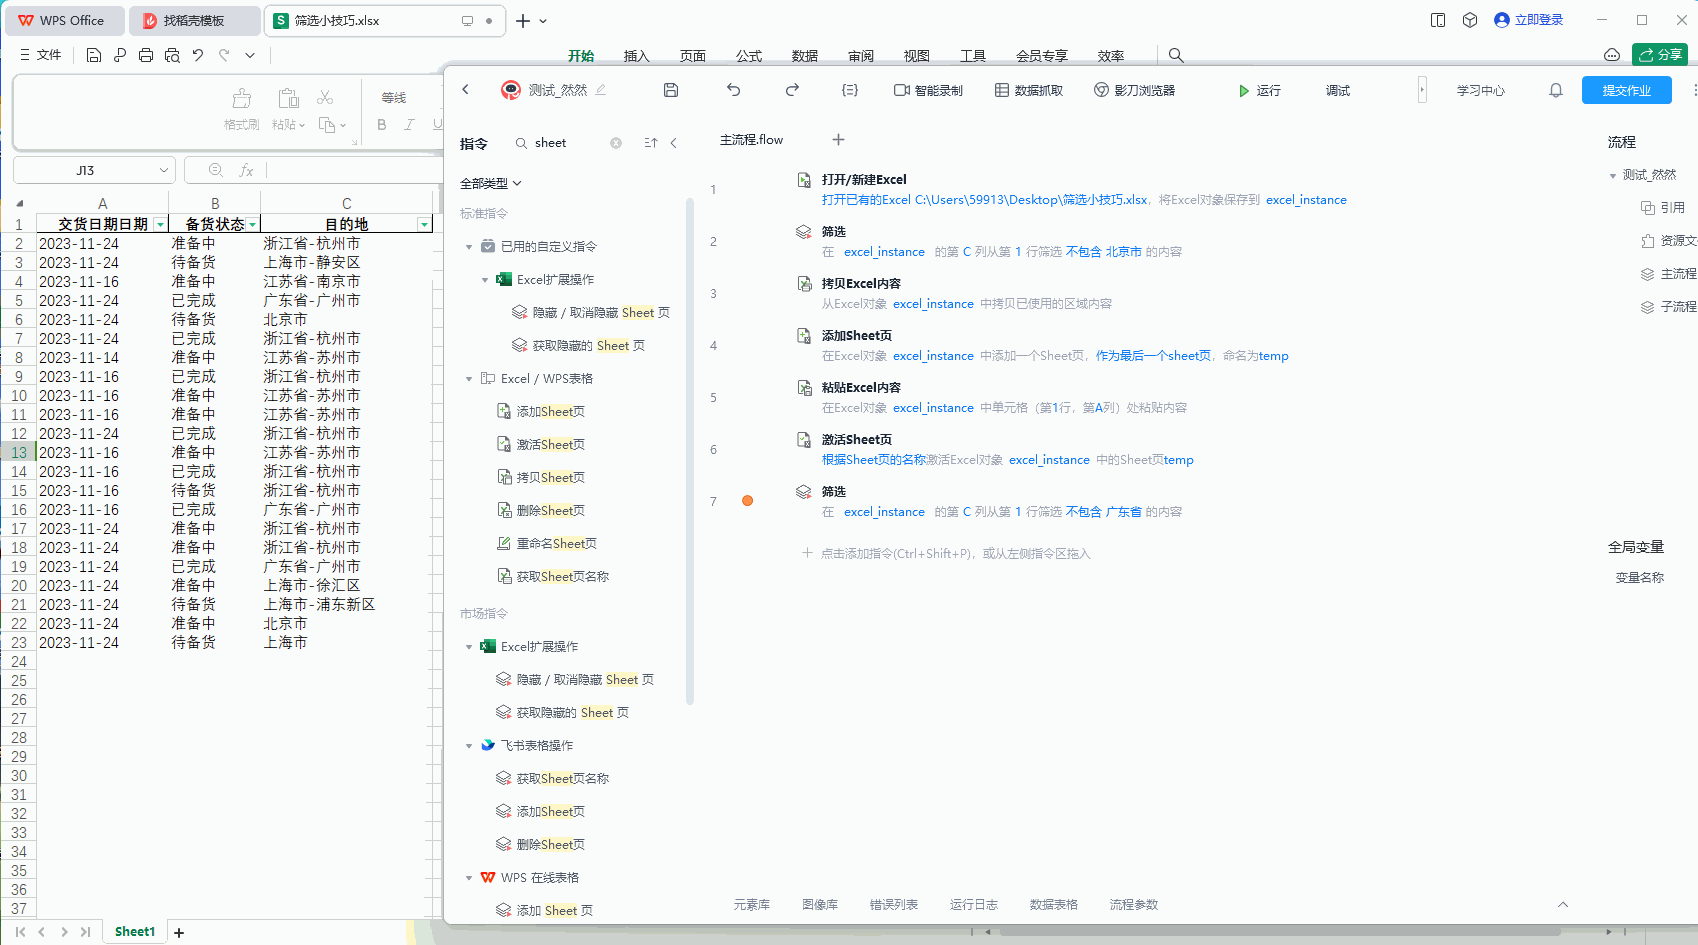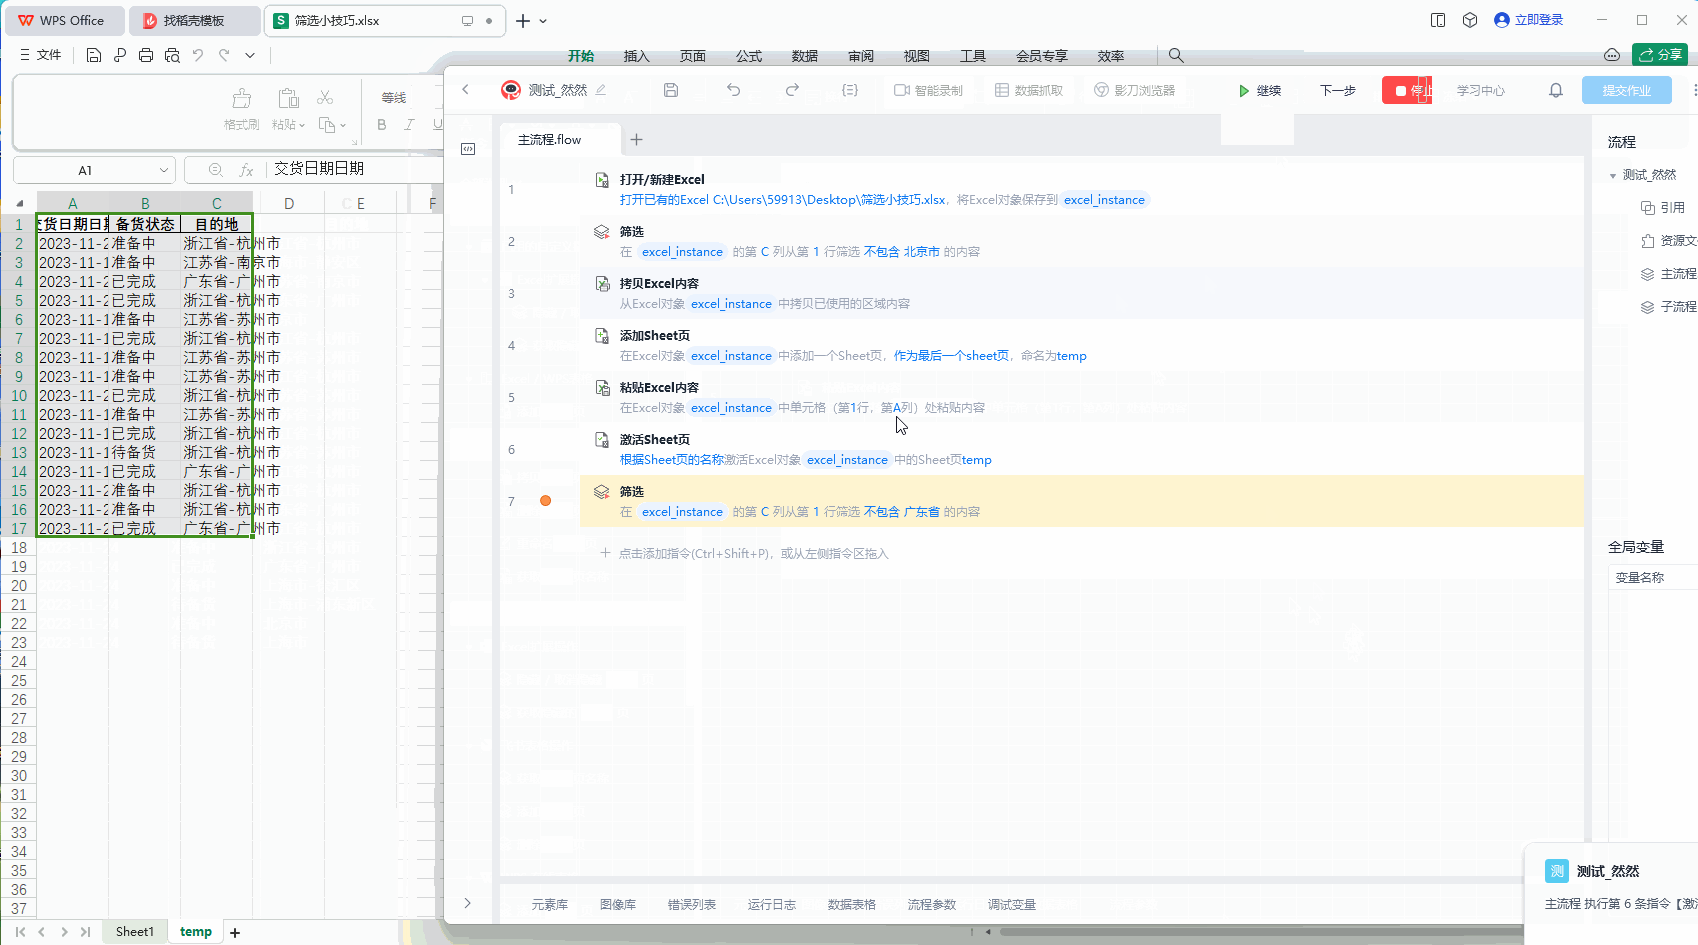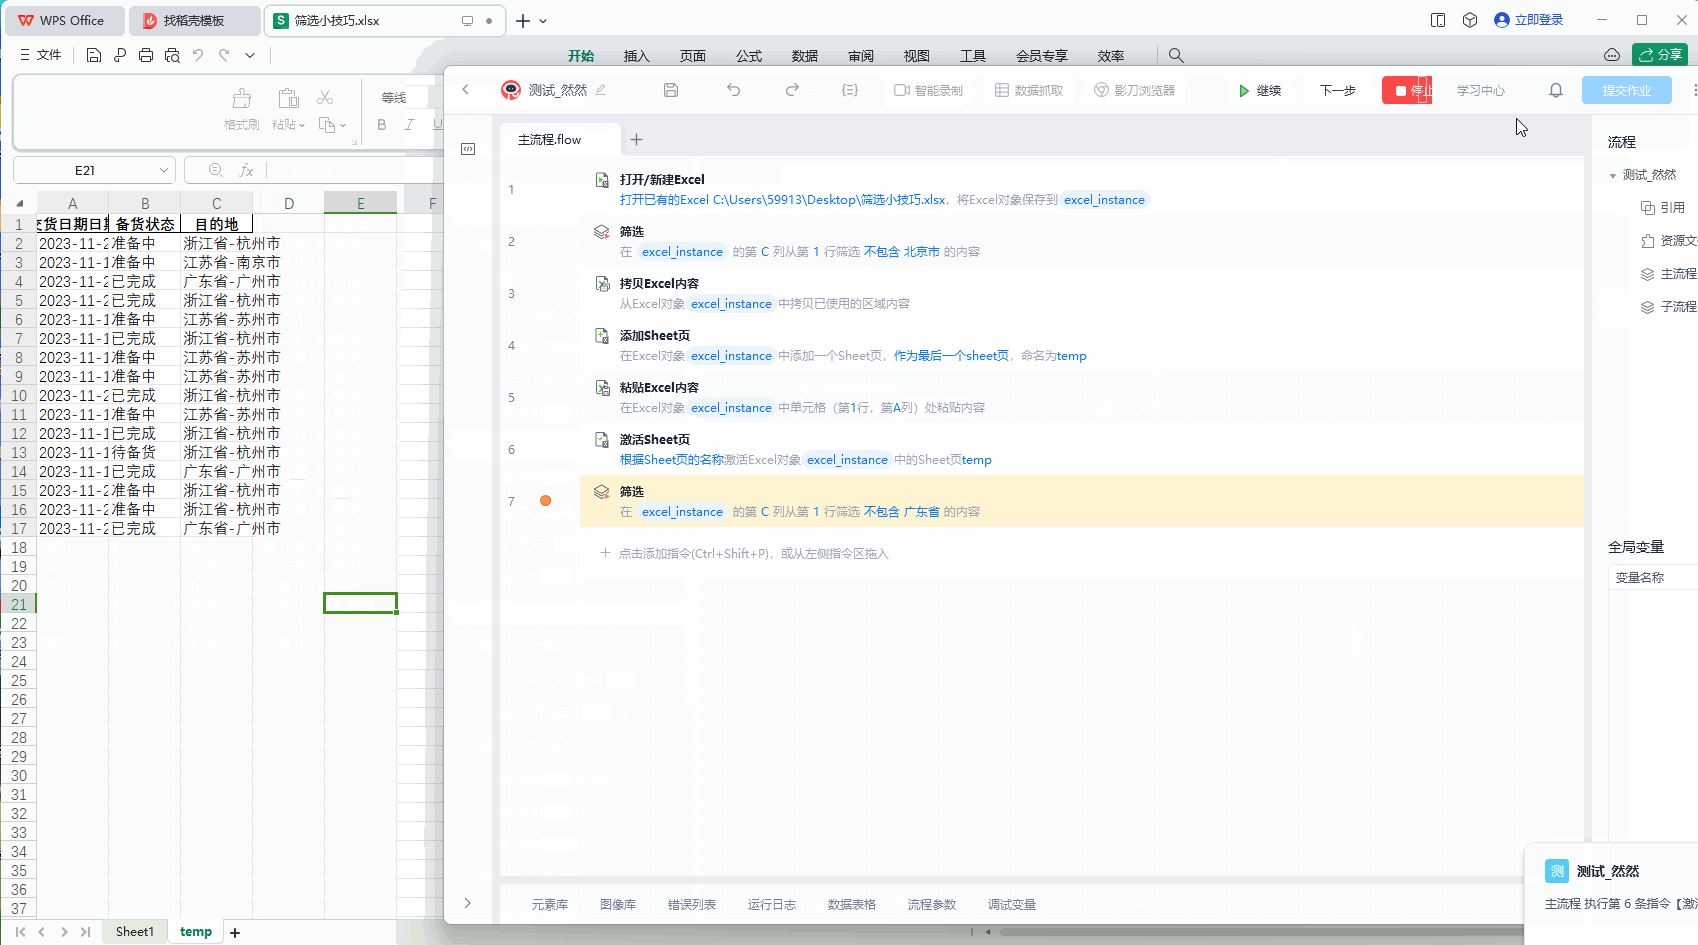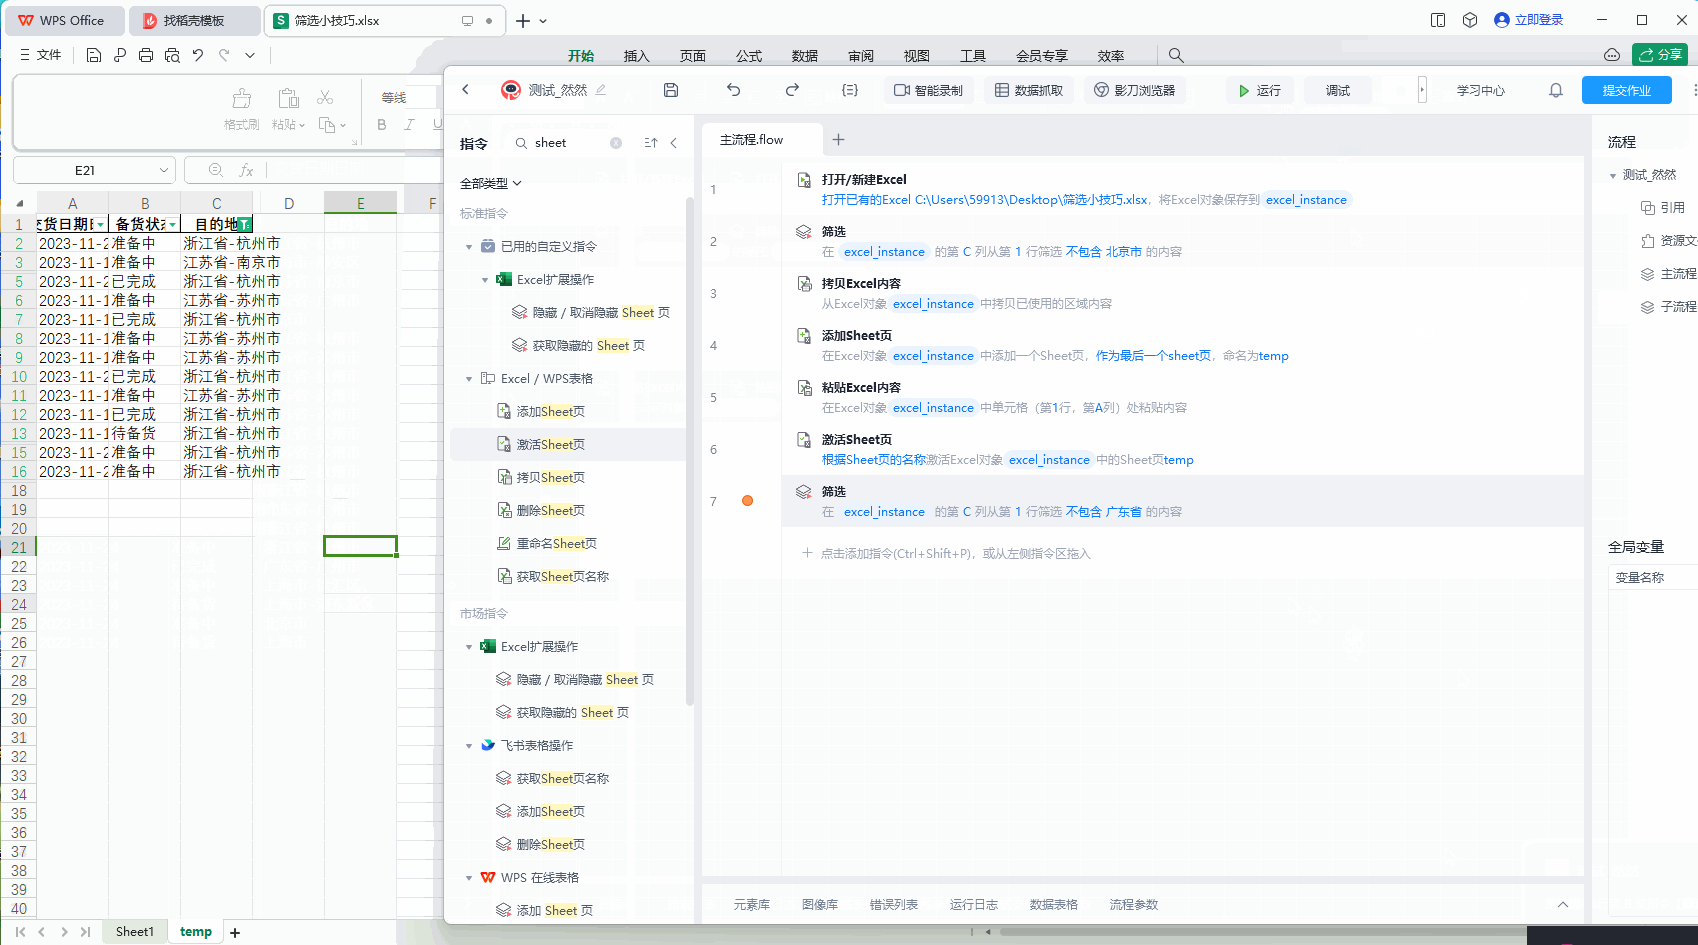
!!!那么问题又双叒叕来了!!! 如果对同一列数据有很多很多个筛选条件,那就得重复拷贝粘贴多次,好像也不是特别方便呢
3.2 编码版传统手艺不能丢~
利用pandas库对excel中的数据进行清洗和过滤。
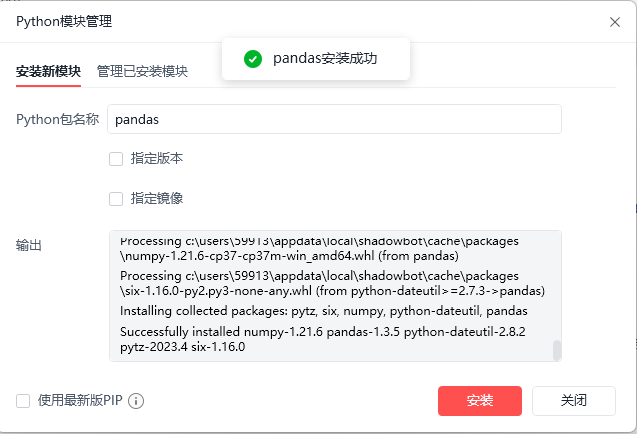
1.在Python模块管理中安装pandas库
2.编写Python代码
def filtered(file_path,active_sheet,filtered_sheet_name,new_file_path):

    #读取当前文件指定sheet页的数据
    df = pd.read_excel(file_path,sheet_name = active_sheet)

    #对读取到的数据进行清洗和过滤
    #筛选条件:备货状态列不等于"已完成" 且 目的地列包含文本"浙江省" 或者包含文本"广东省" 或者等于"上海市"

    filtered_df = df[
        (df["备货状态"] != "已完成") &
        (
         (df["目的地"].str.contains("浙江省")) |
         (df["目的地"].str.contains("江苏省")) |
         (df["目的地"] == "上海市")
        )
        ]

    #打印筛选结果
    print(filtered_df)

    #提供两种筛选结果保存方式,二选一

    #1.将筛选结果写入到当前excel文件的新Sheet页
    with pd.ExcelWriter(file_path, mode='a', engine='openpyxl',if_sheet_exists='replace') as writer:
        filtered_df.to_excel(writer, sheet_name=filtered_sheet_name, index=False)

    #2.将筛选结果写入到新的excel文件中
    filtered_df.to_excel(new_file_path, index=False)
    return new_file_path  #将文件路径传递给主流程进行后续的操作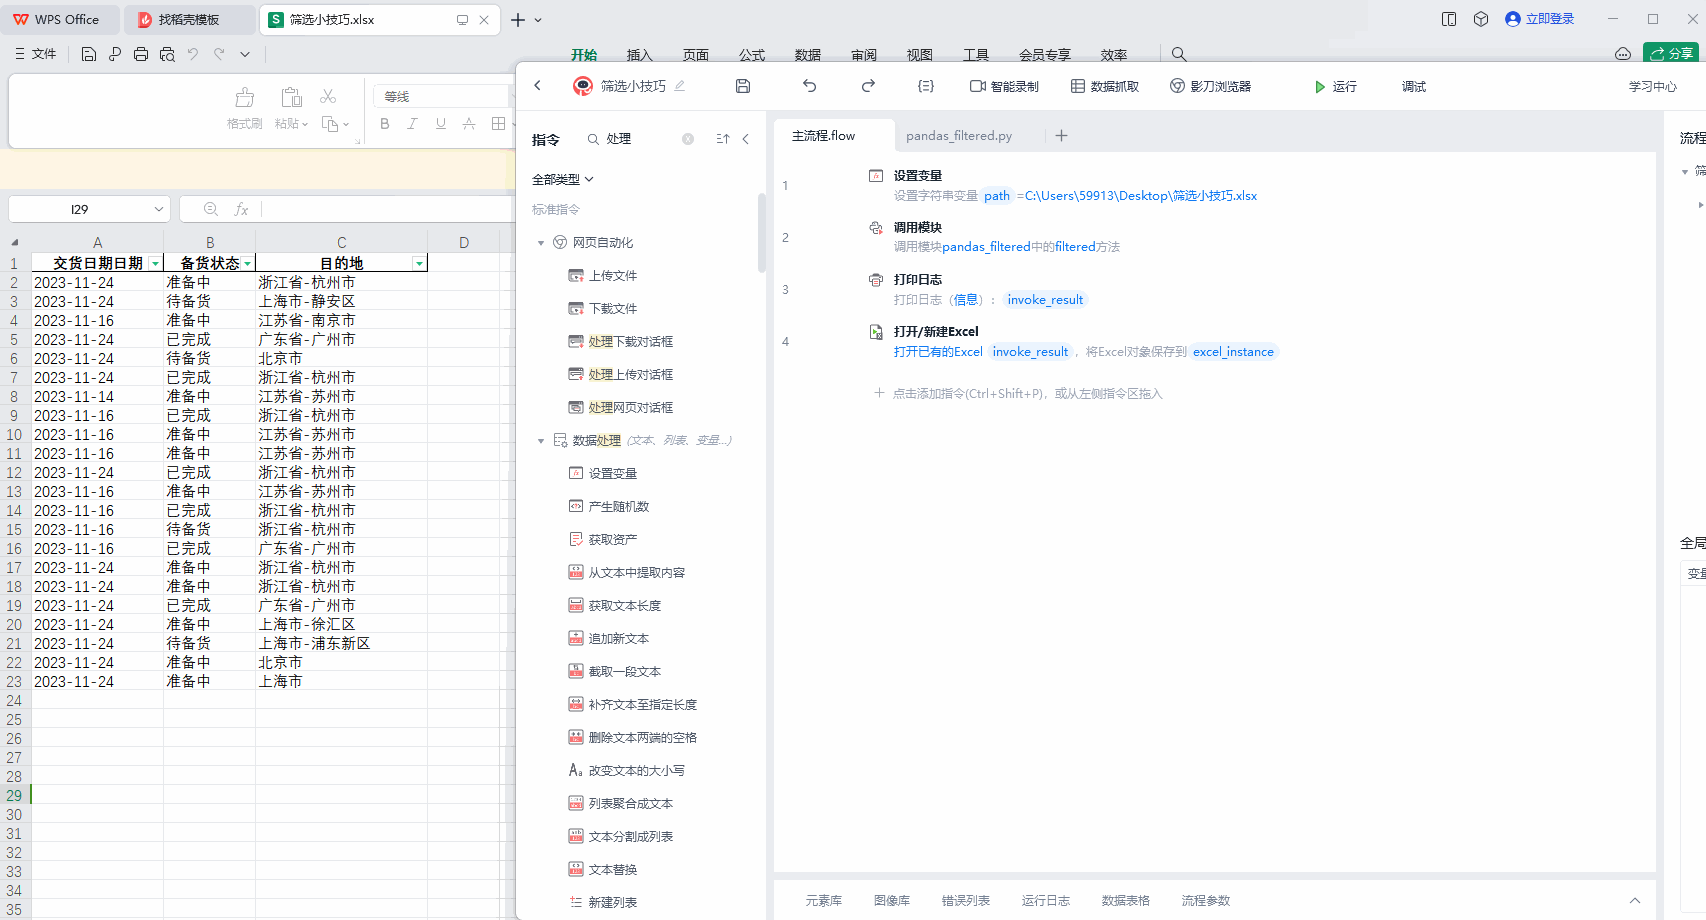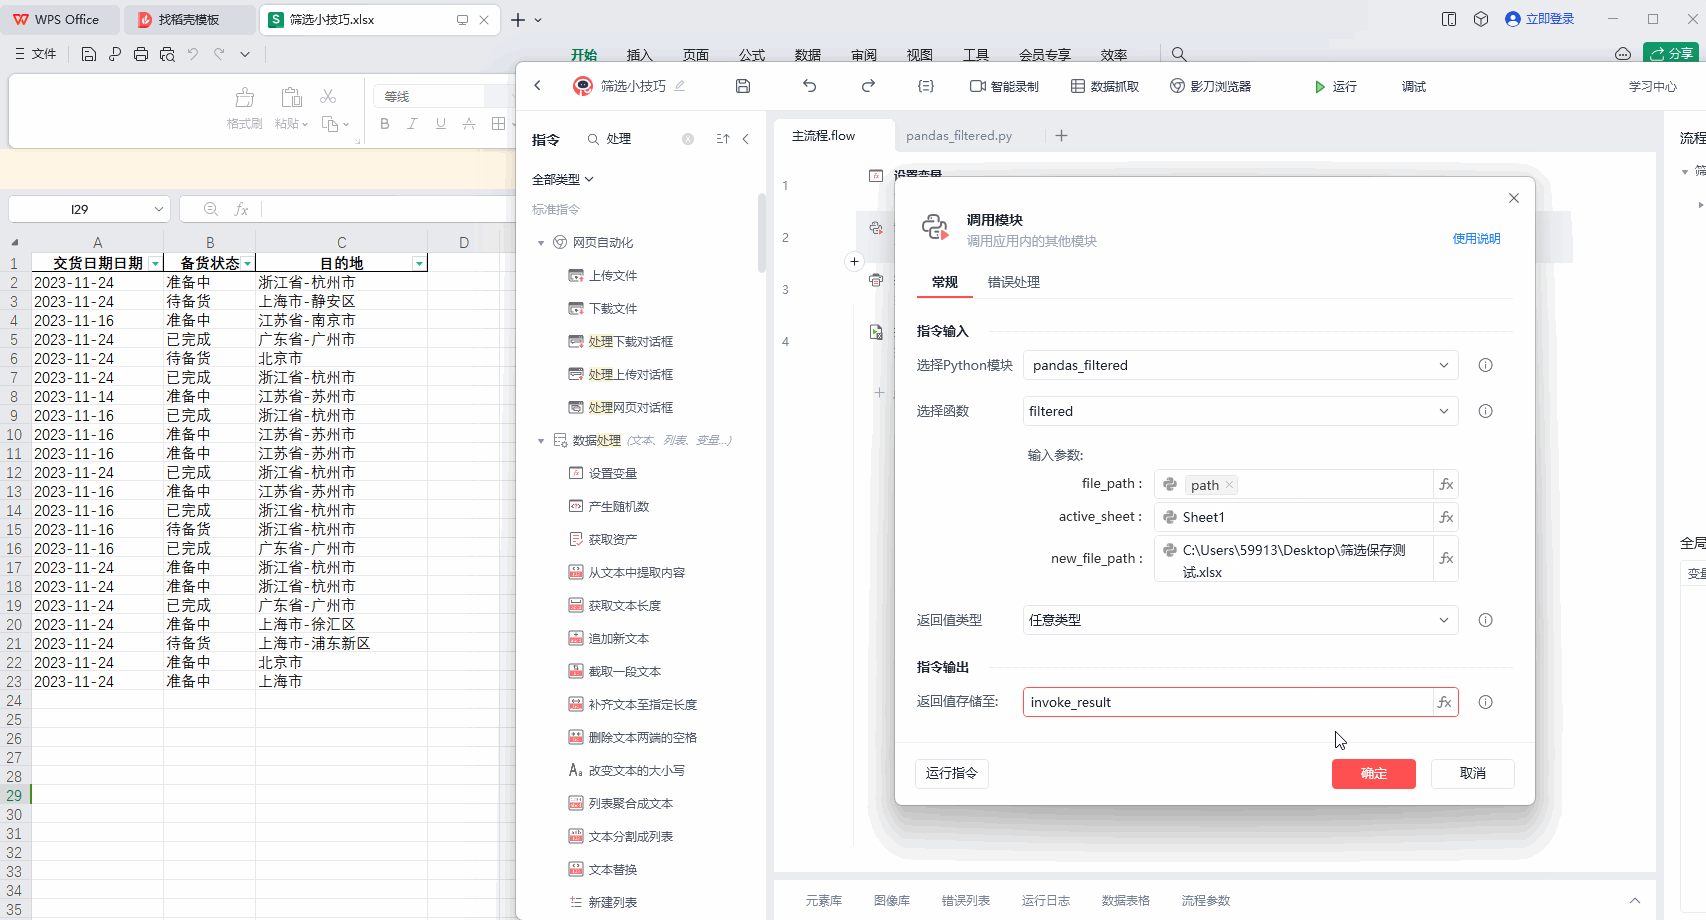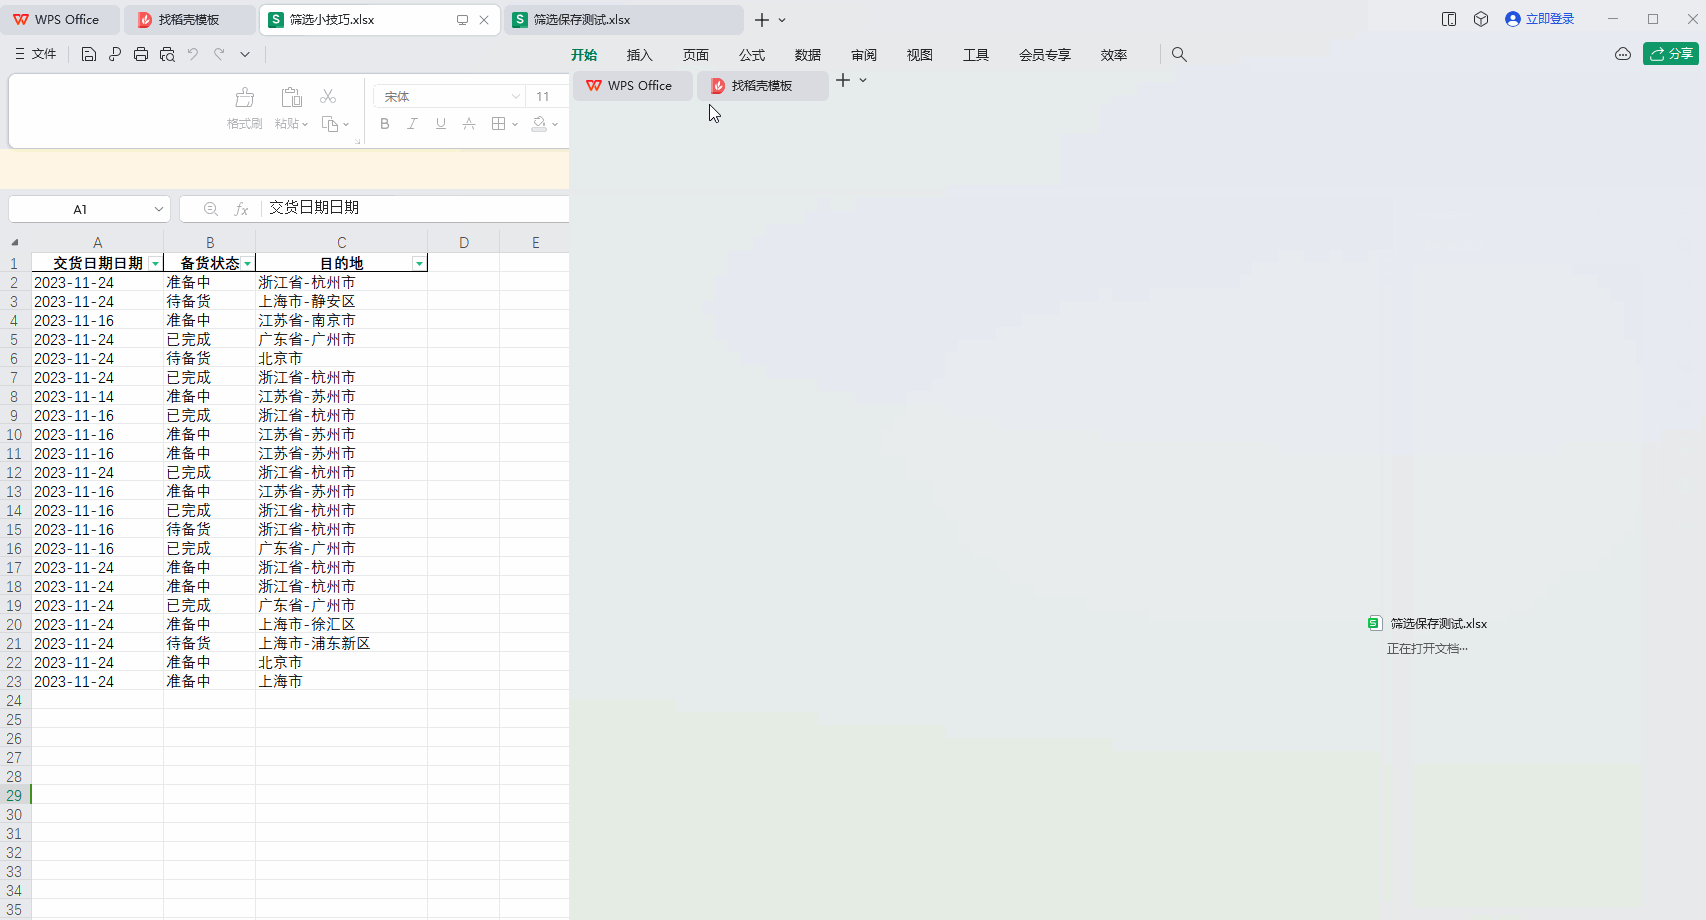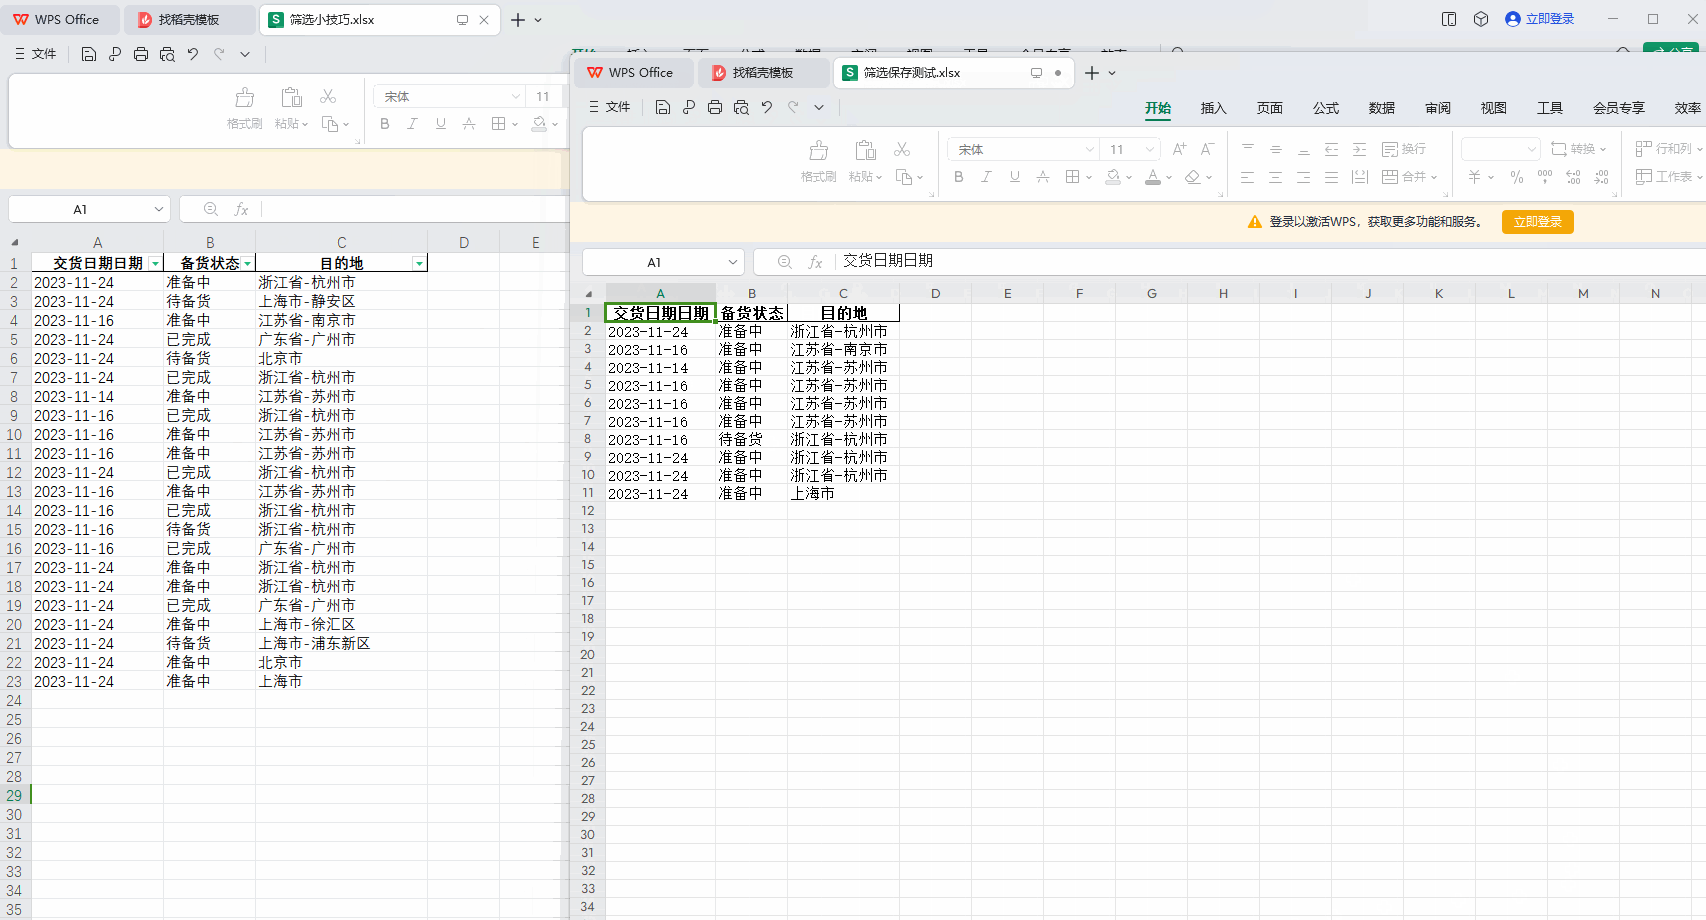
保存方式二选一即可
函数有 file_path active_sheet filtered_sheet_name new_file_path 四个参数,分别代表 源数据excel文件路径、需要筛选的sheet页名称 、 保存筛选结果的sheet页名称、保存筛选结果的新excel文件路径(可以根据自身实际需求更改)。
需要注意的点
1.pandas读取excel文件默认会将第一行数据当成表格的表头,可以通过不同的表头去选中不同的列。如果表格中事先没有表头,可以在read_excel()方法中加上 header=None,即可用列的索引去选中列(0代表A列,1代表B列 依此类推)
2.选择第一种保存方式,运行模块之前需要保证源数据excel文件处于关闭状态。
四、扩展
| == | 等于 | df[df['成绩'] == 100] | 筛选成绩列的值 等于 100的所有行 |
| != | 不等于 | df[df['成绩'] != 60] | 筛选成绩列的值 不等于 60的所有行 |
| > | 大于 | df[df['成绩'] > 60] | 筛选成绩列的值 大于 60的所有行 |
| < | 小于 | df[df['成绩'] < 60] | 筛选成绩列的值 小于 60的所有行 |
| isin([value1,value2....] | 基于列表过滤行,判断数据是否跟列表中的某一项相等 | df[df['成绩'].isin([70,75,80])] | 筛选成绩列的值 等于70或75或80 的所有行 |
| between(value1,value2) | 根据指定范围内的值筛选行 | df[df['成绩'].between(90,100)] | 筛选成绩列的值 在90到100之间 的所有行(包括左右两个区间) |
| str.startswith() | 根据字符串的开头筛选行 | df[df['地址'].str.startswith("浙江省")] | 筛选地址列中以浙江省 为开头 的所有行 |
| str.endswith() | 根据字符串的结尾筛选行 | df[df['地址'].str.endswith("余杭区")] | 筛选地址列中以余杭区 为结尾 的所有行 |
| str.contains() | 根据字符串包含文本筛选行 | df[df['地址'].str.contains("杭州市")] | 筛选地址列中 包含 文本杭州市的所有行 |
| ~ | 非;反选 | df[~df['地址'].str.contains("杭州市")] | 筛选地址列中 不包含 文本杭州市的所有行 |
| | | 或;条件连接符 | df[(df['地址'].str.contains("杭州市")) | (df['地址'].str.contains("宁波市"))] | 筛选地址列中 包含 文本杭州市或者宁波市的所有行 |
| & | 且;条件连接符 | df[(df['地址'].str.contains("杭州市")) & (df['状态'] == "已签收")] | 筛选地址列中 包含 文本杭州市且状态列 等于 已签收的所有行 |
收藏10