收藏
小白提问,在py子模块里写了一个小爬虫,成功解析到了数据,print出来看数值也都是正确的,但是现在不知道怎样把数据导入到主流程里,有大佬能教一下吗
小白提问,在py子模块里写了一个小爬虫,成功解析到了数据,print出来看数值也都是正确的,但是现在不知道怎样把数据导入到主流程里,有大佬能教一下吗?
打印出来的数据是这样的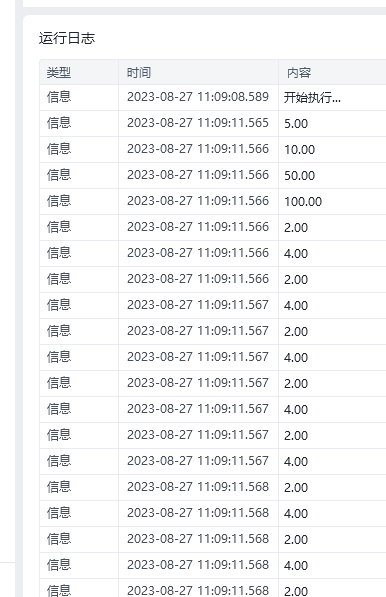 .代码是这样写的
import xbot
from xbot import print, sleep
from .import package
from .package import variables as glv
import requests
from bs4 import BeautifulSoup
headers = {
"user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/116.0.0.0 Safari/537.36"
}
def main(x):
pass # 在函数中打印变量num的值
b = glv["a"]
response = requests.get(b, headers=headers)
soup = BeautifulSoup(response.text, 'html.parser')
# 采集<span class="currency-value">*</span>的内容
currency_values = soup.find_all('span', class_='currency-value')
# 输出结果
for value in currency_values:
print(value.text)
pass
return glv["result"] # 结束代码的执行
# 调用
用了两个全局变量,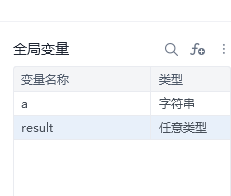 ,全局变量a是把主流程里当前循环的网址导入py子模块. 但是现在不知道怎么把采集结果导回去,求教
收藏