影刀RPA_读取文件 编码不一样 怎么办_by上海小可耐 收藏
回答
收藏影刀RPA_读取文件 编码不一样 怎么办_by上海小可耐
2023-04-03 09:39·浏览量:1161
小可耐教你学影刀RPA【哔哩哔哩同名】
用户场景
用户文件夹下面有很多txt文件,但是文件里面里面的编码可能不一样。可能是ASCII、ANSI、GB2312、GBK、UTF8 和 Unicode (https://www.cnblogs.com/xtuz/p/12448200.html 关于编码详细了解可以参考这个文章)
如果我们读取文件指定一个编码可能会导致流程报错,,,那怎么解决呢

如何解决
通过代码解决
解决不同编码的txt 通用读取方式 安装模块chardet
# 使用提醒:
# 1. xbot包提供软件自动化、数据表格、Excel、日志、AI等功能
# 2. package包提供访问当前应用数据的功能,如获取元素、访问全局变量、获取资源文件等功能
# 3. 当此模块作为流程独立运行时执行main函数
# 4. 可视化流程中可以通过"调用模块"的指令使用此模块

import xbot
from xbot import print, sleep
from .import package
from .package import variables as glv
import chardet
def main(args):
    pass
# 获取文件编码类型
def get_encoding(file):
    # 二进制方式读取,获取字节数据,检测类型
    with open(file, 'rb') as f:
        return chardet.detect(f.read())['encoding']


def 读取任意编码的txt(filepath):
    encoding = get_encoding(filepath)
    with open(filepath, 'r', encoding=encoding) as text:
        txt = text.read()
        return txt
可视化界面

利用多try解决
首先设置一个空变量

在后面的流程中进行try和重新赋值
默认编码
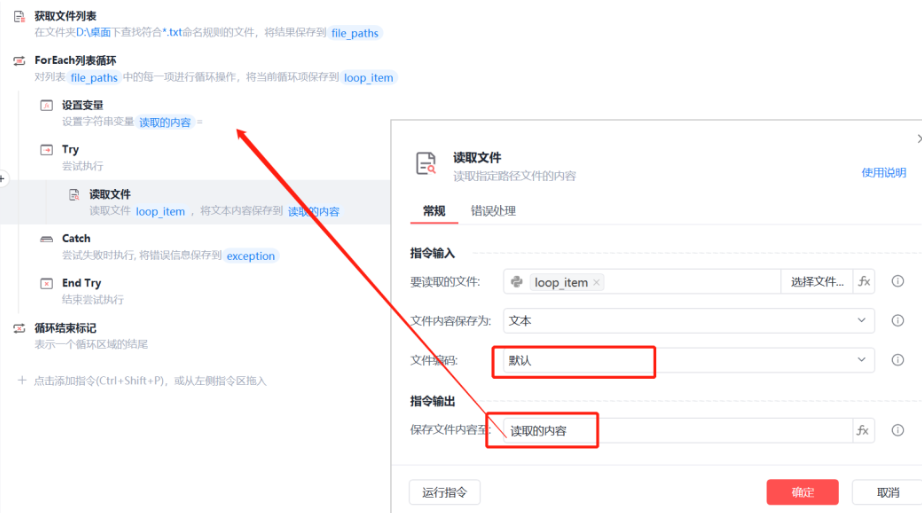
ansi

以此类推 加入其他编码
收藏全部回答(1)
最新
发布回答
回答