如何利用截图方式提取有涂改的pdf 收藏
评论
收藏如何利用截图方式提取有涂改的pdf

2024-02-27 17:36·浏览量:690
克林
作者:克林
背景
在帮客户解决pdf提取问题过程中,客户的pdf有90%左右都是有涂改的,因此不能跳过整张png,客户的需求是有涂改的就显示异常值。
我发现有涂改的pdf提取根本做不了,涂了后很可能把隔壁的字段黏在一起。如图:
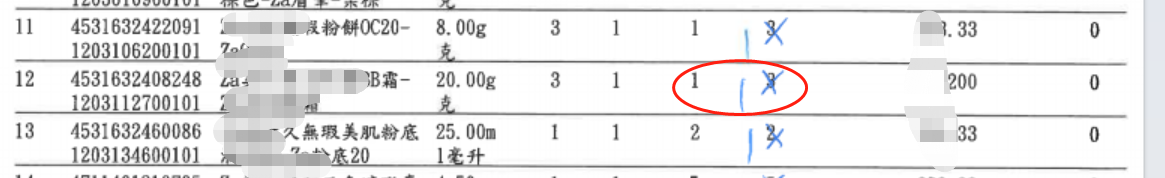
图中可能会识别成:11,汉字(为,x等)两个字段,也可能是1,1,汉字(为,x等)三个字段。尝试过ocr+正则,提取不了,都是数字,顺序也是乱序。后面又尝试过表格识别,但是容易黏上隔壁的字段,造成字段偏移(多一个字段少一个字段),或者字段值错误。
方法
采用先截图后识别的方法。先单独把红色区域的地方单独截图成png,再去用ocr表格识别,可极大的提高识别的通过率。
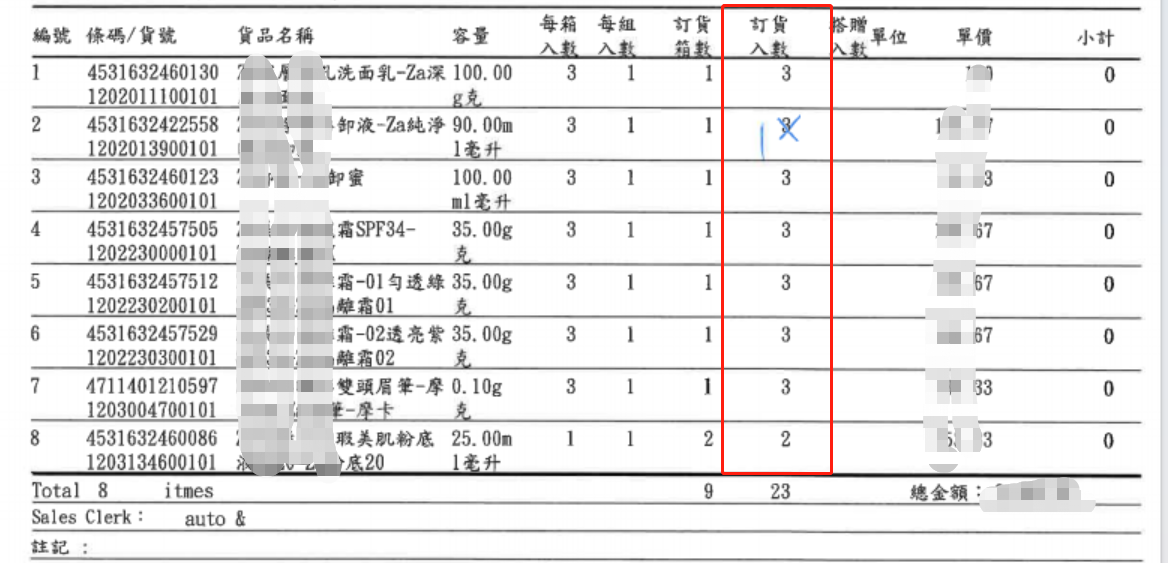
效果
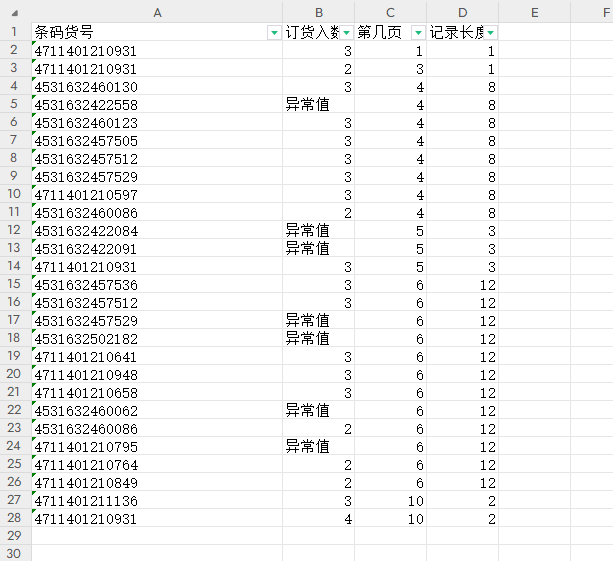
尝试提取10页,提取出来6页,有些除了异常值之外的数据也是错的,但是相比业务同事手动去完全登记已经方便很多了,只需要看看当前页有没有问题,有问题就修改几处,而不是从一个空白的表格去一个个字段登记,相当于预填。
最后附上沐春大神的图片区域截图方法:
https://www.yingdao.com/community/detaildiscuss?id=3b6f8196-c8f5-441f-9055-91e4acdcbc0f
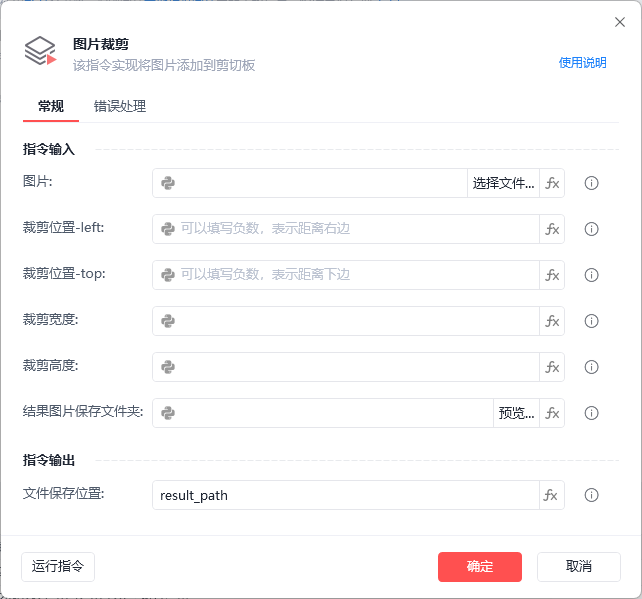
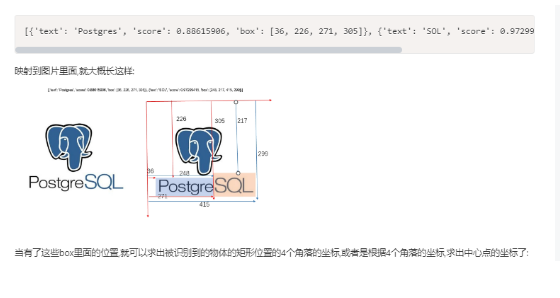
思路:通过某些文字的坐标+图片裁剪指令,算出要截取的长度和宽度和起始位置,就能实现图片的任意区域截图了,不一定要用在这个方案上。

收藏1全部评论(1)
最新
发布评论
评论