批量下载网页上的图片老是出错 收藏
回答
收藏批量下载网页上的图片老是出错
老
2024-03-19 11:49·浏览量:268
老
老蔡合天
就是普通的文章网页,上面有几幅图,想批量下载。
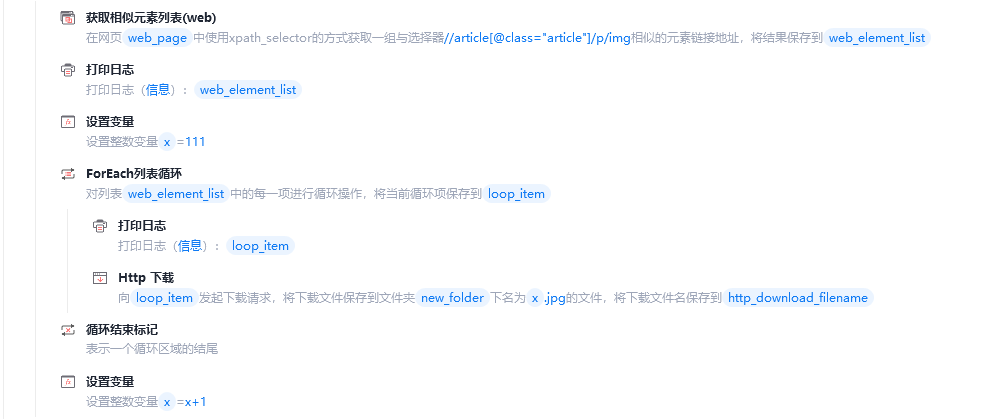
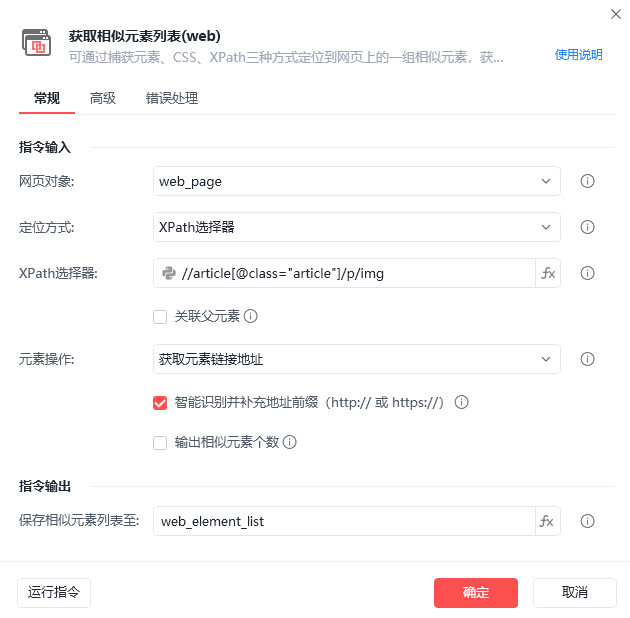
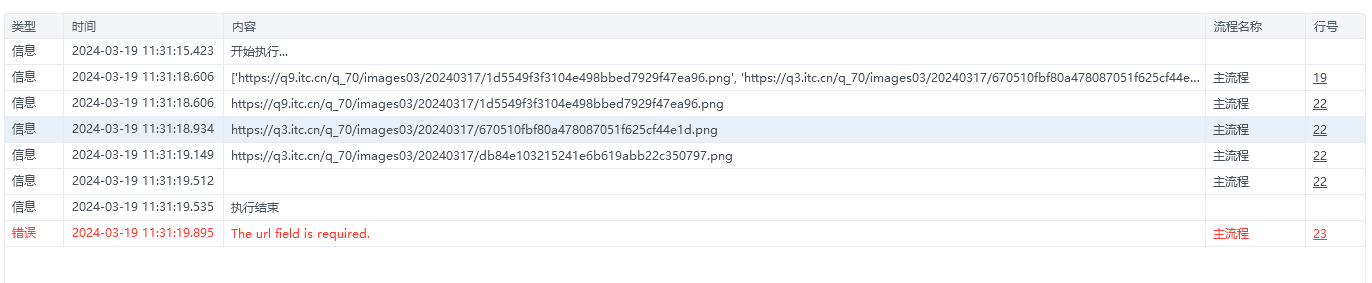
获取相似列表,获取图片链接,循环每个图片的链接,打印出来看都没问题,挨个手动把打印日志里的链接复制去浏览器打开都没问题。
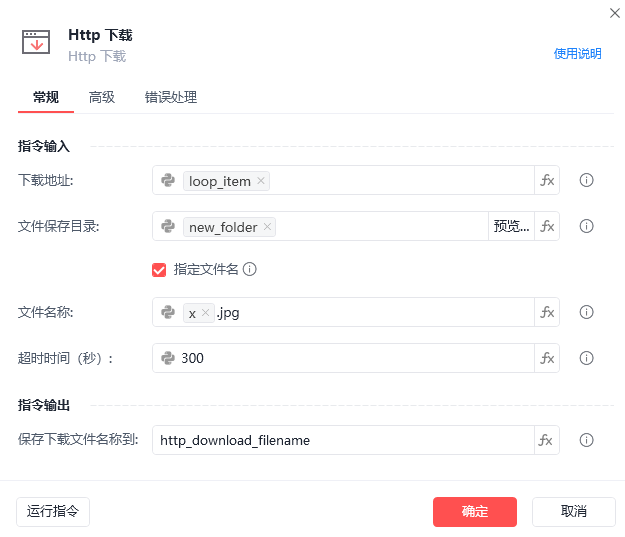
但就是老是报错,有时候行有时候不行,这次运行就只是下载了第1张图,后面2张都没下载,排查了很久都不知道哪里出问题。
尝试过获取元素信息,或者获取元素属性的方法,都能得出图片的链接,就是下载那里老是报错,是哪里有问题啊?
会不会是获取相似元素列表那里,xpath的代码不准确?但是又能读出来。
网址是搜狐的:https://www.sohu.com/a/764808054_116237?scm=
收藏全部回答(1)
最新
发布回答
回答